RemoteANN:面向云对象存储的原生向量搜索引擎
- 原文标题:RemoteANN: A Native Vector Search Engine for Cloud Object Storage
- 原文版本:arXiv:2610.25172v1
- 发布日期:2026-10-18
- 翻译与整理日期:2026-10-21
- 在线原文:PDF、HTML
- 图表截图清单:来源、页码和裁剪信息
- 写作规范:阮一峰《中文技术文档的写作规范》
| 作者 | 所属机构 | 电子邮箱 |
|---|---|---|
| Yutong Gou | 南洋理工大学,新加坡 | yutong003@e.ntu.edu.sg |
| Silu Huang | 字节跳动,美国 | silu.huang@bytedance.com |
| Yue Wang | 字节跳动,美国 | yue.w@bytedance.com |
| Jianjun Chen | 字节跳动,美国 | jianjun.chen@bytedance.com |
| Cheng Long | 南洋理工大学,新加坡 | c.long@ntu.edu.sg |
翻译说明:本文按原文章节翻译摘要、正文、结论、图表说明、算法和全部脚注。文中的“我们”指原论文作者,实验结果均为作者报告的结果。参考文献保留原文著录信息,以便检索。图表和算法截图来自上述 PDF,保留图内英文;相邻文字提供中文说明。图片所注页码为 PDF 页码。
许可与改动:原论文由上述作者以 CC BY-NC-SA 4.0 许可发布。本中文翻译及图表裁剪沿用该许可。本文进行了中文翻译、段落重排和图片裁剪,未改动图表数据;译文未经原作者审核,不代表原作者认可。
摘要
基于云对象存储的向量搜索引擎,正受到学术界和工业界的广泛关注。这类系统通常采用存算分离架构:将主要向量数据持久化到对象存储中,例如 Amazon S3;在计算节点上保留紧凑的索引元数据。
然而,传统向量索引并未针对云对象存储设计。它们难以适应较高的网络延迟和按请求次数计费的访问成本,因而产生网络 I/O 放大、查询吞吐量下降和 API 费用增加等问题。
为解决这些问题,我们提出 RemoteANN。该向量搜索引擎面向云对象存储,协同设计索引和查询机制。为缓解主要的网络 I/O 瓶颈,RemoteANN 将倒排文件索引(Inverted File,IVF)与 RaBitQ 量化结合,并通过簇间和簇内数据重排改善数据局部性。
在这一数据布局之上,查询引擎结合了簇剪枝、细粒度 Range-GET 请求、请求合并和本地 NVMe SSD 缓存。这些机制在保持准确率的同时,大幅减少独立存储请求的数量和网络传输量。为解决索引构建瓶颈,我们还提出 QGKMeans,在保持聚类质量的同时显著缩短构建时间。
在真实数据集上的广泛评估表明,当目标召回率为 97% 时,与有代表性的基线相比,RemoteANN 的吞吐量最高可达到基线的 5.9 倍,对象存储请求数最低可降至基线的约 1/16.1。
1 引言
云对象存储平台具有水平扩展能力、较高的数据持久性和成本效益,因此成为现代数据库系统颇具吸引力的存储后端。典型平台包括 Amazon S3 [3]、Azure Blob Storage [50] 和 Torch Object Storage [12]。
这种架构将计算与存储解耦。无状态计算实例负责执行查询,例如 AWS EC2 [2];主要数据则交由具有弹性的远程对象存储保存。基于这些基础设施优势,学术界和工业界开始将这一模式用于向量数据库,以及近似最近邻搜索引擎(Approximate Nearest Neighbor,ANN)。例如 Amazon S3 Vectors [4]、Turbopuffer [61]、Lance [46] 和 Databricks [53]。在这些系统中,紧凑的索引元数据和路由结构位于计算节点的本地存储,大部分高维向量数据则持久化到云对象存储。
然而,传统向量索引并不天然适用于云对象存储。直接部署会导致查询性能不佳,并增加运行成本。首先,与动态随机存取存储器(DRAM)和本地固态硬盘(SSD)相比,云对象存储的数据读取具有较高的首字节时间(Time to First Byte,TTFB)。对于小数据量请求,这部分网络延迟占据下载总延迟的主要部分 [19]。因此,基于图的索引 [22, 40, 49] 会因反复、多跳的路由过程而出现明显的性能下降。现有云对象存储向量搜索系统因此主要采用基于聚类的索引,例如 Lance 的 IVF [46],以及 Turbopuffer [61] 采用的 SPFresh [65]。
其次,云服务商会按独立存储请求的数量收取可观费用。传统面向本地存储的索引设计没有考虑这一成本。简单的实现可能发出过多请求,造成难以承受的 API 开销。尽管如此,现有系统尚未针对云对象存储的延迟和成本特征,同时优化索引布局、索引构建和查询执行。
为弥补这一缺口,我们提出专为云对象存储设计的向量搜索引擎 RemoteANN。我们在索引、查询和存储层次之间协同设计算法与系统,系统性地缓解限制向量搜索的网络 I/O 瓶颈。RemoteANN 在索引和查询方面的贡献如下。
面向查询的索引与数据布局。 RemoteANN 将 IVF 索引与 RaBitQ 量化结合 [25, 27]。沿用已有框架的思路,它将索引元数据和 1 位 RaBitQ 编码保存在 DRAM 中,将主要向量数据保存在云对象存储中。驻留内存的编码支持在读取远程数据之前执行剪枝;簇间和簇内数据重排则改善物理局部性。这些设计显著增强了查询阶段 I/O 优化策略的效果。
为降低索引构建成本,我们开发了 QGKMeans。它利用 SymphonyQG [31] 加速 $k$-means 聚类中的质心分配步骤,在保持聚类质量的同时显著缩短索引构建时间。
协同设计的查询引擎。 RemoteANN 提供针对云对象存储的多层查询优化框架。该框架利用 RaBitQ 给出的解析误差界执行簇剪枝;通过范围优化,让 Range-GET 请求仅下载覆盖候选向量所需的最小字节区间;通过请求合并减少 API 成本;通过本地 NVMe SSD 缓存跳过远程 I/O。在配套数据布局的支持下,这些组件共同降低云端 I/O 开销,同时保持查询性能。
我们使用不同维度、不同规模的真实数据集评估 RemoteANN。结果证实了针对特定环境设计索引和查询机制的有效性。在广泛实验中,相对于有代表性的基线,RemoteANN 的吞吐量最高达到其 5.9 倍,独立存储请求数最低降至其约 1/16.1。
2 基础知识
2.1 云对象存储
云对象存储是云服务商提供的在线对象存储服务 [3, 12, 30, 37, 50, 52, 60]。它在多个存储节点和服务器之间组织分布式环境,提供较高的数据持久性、平滑的水平扩展能力和良好的成本效益,适合保存海量非结构化数据。
云对象存储与本地存储的主要差异有两个:计费模式和底层 I/O 特性。基于它构建系统时,必须认真考虑这两点。首先,读取数据时,云服务商主要按请求次数计费。1 其次,网络通信引入的 TTFB 开销会造成较高的读取延迟,通常达到数十毫秒。已有研究指出,对于小数据量请求,TTFB 是总延迟的主要来源 [19]。
2.2 云对象存储上的向量搜索
云对象存储的优势推动了相关 ANN 搜索引擎的发展,例如 Amazon S3 Vectors [4] 和 Turbopuffer [61]。如图 1 所示,这类系统通常包含两层:计算实例利用本地内存和磁盘缓存索引元数据;云对象存储负责持久化主要索引数据。
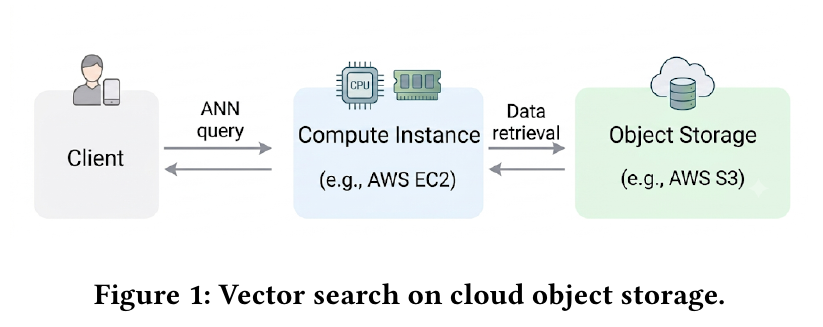
图 1:云对象存储上的向量搜索。 图中的 Client 为客户端,Compute Instance 为计算实例,Object Storage 为对象存储。客户端向计算实例发起 ANN 查询,计算实例再读取对象存储中的数据。来源:原论文第 2 页。
为缓解云对象存储较高的 TTFB 开销,这些引擎主要采用基于聚类的 ANN 索引,例如 IVF 变体和 SPFresh [4, 18, 61, 65]。在内存或磁盘场景中常见的图索引 [22, 40, 49],则并非这里的主要选择。
原因在于,聚类索引只需一次网络往返,就能从云对象存储获取全部目标向量数据。图索引的迭代路由则需要多次网络往返,TTFB 开销不断累积,最终推高端到端查询延迟。
2.3 RaBitQ 量化
在向量搜索中,量化是一类压缩技术。它将高维向量压缩为紧凑的低位宽编码 [6, 9, 10, 25, 27, 29, 33, 41, 62, 63, 66, 67],查询时再利用这些编码估计距离。近期提出的 RaBitQ 量化框架 [24, 25, 27],旨在解决经典量化方法缺乏理论支撑的问题。
对 $D$ 维向量建立索引时,RaBitQ 先利用均匀网格构造包含 $2^{B\cdot D}$ 个单位向量的码本。其中,$B$ 表示每个维度分配的位数。随后,通过 Johnson-Lindenstrauss 变换 [42] 对码本进行随机旋转。每个数据向量经过归一化后,再量化为码本中距离最近的码字。
查询时,RaBitQ 根据码字估计查询向量与数据向量之间的距离。严格的理论分析表明,RaBitQ 估计器是无偏的,并具有理论误差界。这使它在真实工作负载中取得了较高的检索准确率 [25]。
3 方法
本节介绍云端向量搜索框架 RemoteANN 的完整系统设计,说明针对这一环境的索引构建和查询处理优化。如第 2.1 节所述,云对象存储具有较高的 I/O 延迟。因此,我们选择 IVF 索引,使每次查询能够通过一次网络往返获取目标簇。为进一步降低云端 I/O 开销,我们在索引和查询两侧进行协同优化。
第 3.1 节介绍索引流水线,包括结合 RaBitQ 量化的异构存储布局(第 3.1.1 节)、高效的 IVF 聚类加速方法(第 3.1.2 节),以及改善数据局部性的数据重排策略(第 3.1.3 节)。
第 3.2 节介绍查询处理框架。对于部署在云对象存储上的 IVF 索引,查询引擎先利用计算节点上的元数据,为查询向量确定 $n_{\text{probe}}$ 个目标簇,再从云对象存储获取相应数据。为降低云端 I/O 开销,我们采用四种策略:基于 RaBitQ 的簇级剪枝、细粒度范围优化、请求合并和缓存,分别见第 3.2.1 至 3.2.4 节。
这些组件在结构上协同设计。索引构建阶段形成的数据布局,直接决定并支持查询阶段的高效 I/O 操作。第 3.3 节总结 RemoteANN 的索引和查询流程。
3.1 索引阶段
3.1.1 结合 RaBitQ 量化的 IVF 索引存储布局
如第 2 节所述,云对象存储上的向量搜索由计算节点和云对象存储组成,形成三个存储层次:本地 DRAM、本地磁盘和远程存储。为降低运行成本,系统可以在空闲时只将全部数据保存在云对象存储中。
查询到来时,系统需要启动计算实例,并通过网络读取所需数据。这会造成严重的冷启动开销,使初次查询延迟过高。通过系统层面的协同设计,可以缓解这一问题。例如,将向量搜索引擎接入交互式下游应用时,用户的输入行为可以作为提前预取的信号。对于对话式 AI 智能体,后端可以在用户开始打字时异步下载索引元数据,从而隐藏冷启动延迟。
因此,本文聚焦于预热后的查询处理:高精度向量数据始终保存在云对象存储中;查询期间,常用索引元数据,例如 IVF 簇质心,固定驻留在计算节点主存中。下面介绍具体的数据布局。
计算节点的 DRAM 缓存高维质心向量和低精度量化向量,作为路由索引。具体而言,我们利用 RaBitQ [25, 27],将原始高维向量压缩为每维 9 位的表示。2 再将这 9 位拆成 1 位前缀和 8 位后缀:前缀驻留本地 DRAM,后缀持久化到云对象存储。如果计算实例配有本地 NVMe SSD,还可以将其作为中间缓存,保存常用簇的 8 位后缀。
这种分离式量化方案主要用于优化云对象存储 I/O,因为这是整个系统的主要性能瓶颈。RaBitQ 提供具有严格理论保证的高精度距离估计。因此,查询引擎可以利用内存中的 1 位前缀剪除向量和簇,同时减少独立 Range-GET 请求数和下载数据量。具体机制见第 3.2 节。
3.1.2 利用 QGKMeans 加速 IVF 索引构建
传统 ANN 搜索通常通过 $k$-means 聚类划分数据集,进而构建 IVF 索引。已有研究指出,$k$-means 需要反复将向量分配给质心,因此成为 IVF 索引构建的瓶颈 [8, 18, 25, 56]。为降低这一成本,已有工作将 ANN 搜索技术用于 $k$-means 迭代中的质心分配 [17, 44, 57, 64]。
受这些研究启发,我们提出新的 $k$-means 变体 QGKMeans。它使用 SymphonyQG [31] 加速开销较大的向量到质心分配。每轮迭代中,我们先为当前质心构建 SymphonyQG 索引,再用每个数据向量查询该索引,找到近似最近的质心。这样,每轮迭代都需要大量搜索;质心更新后,还需要重建搜索结构。已有研究和基准测试表明,SymphonyQG 在查询和索引构建两方面都具有较高效率 [31, 39],因此适合承担这一加速任务。
我们从聚类耗时和聚类质量两方面,对比 QGKMeans、Faiss [18]、SuperKMeans [44] 和 SeededANN [57]。Faiss 提供广泛使用的参考实现。SuperKMeans 通过维度剪枝 [26] 和优化的数据布局 [45] 加速相同工作负载。SeededANN 则代表利用分层可导航小世界图(HNSW)加速质心分配的方法。
所有变体均使用完整原始向量集,执行 25 轮迭代。我们关闭数据采样和层次聚类,以便在相同的扁平 $k$-means 工作负载下比较。关闭这两项功能,是因为它们都容易与各类 $k$-means 变体组合。按照文献 [44] 的评估标准,我们测量总聚类时间、簇内平方和(Within-Cluster Sum of Squares,WCSS),以及探测固定比例簇时的下游 IVF 召回率。
所有变体均在 Intel Xeon Gold 6418H CPU 上运行,固定使用 48 个并发线程。表 1 汇总了实验结果。QGKMeans 在保持相近 WCSS 和下游召回率的同时,取得了最短聚类时间。相对于最快的基线,它在 SIFT 上的加速比为 1.4,在 Cohere 上为 5.5。因此,后续实验均使用 QGKMeans 生成簇。
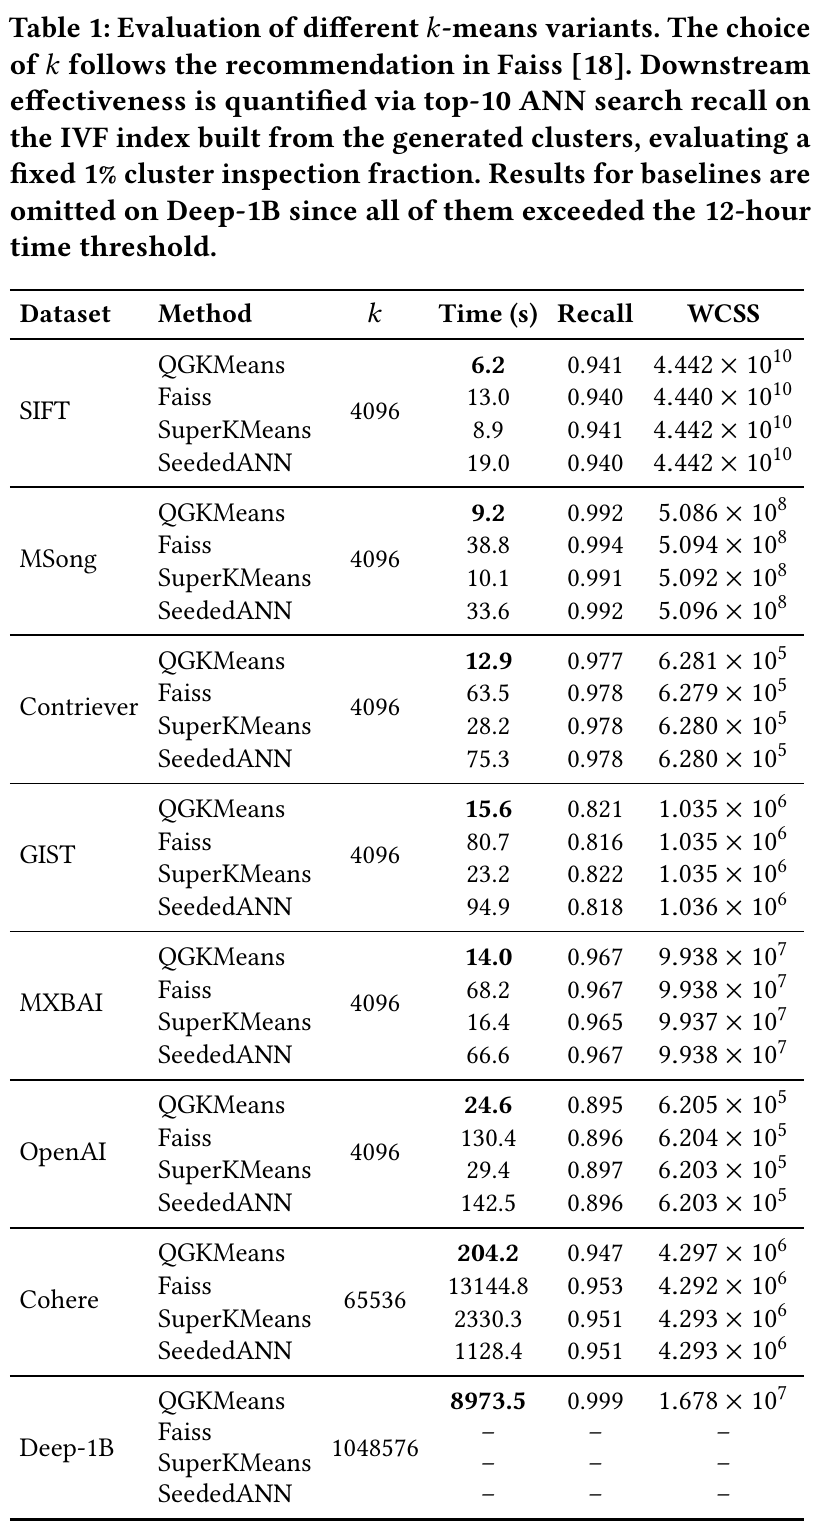
表 1:不同 $k$-means 变体的评估。 $k$ 的选择遵循 Faiss 的建议 [18]。下游效果通过 top-10 ANN 搜索召回率衡量:先用生成的簇构建 IVF 索引,再固定检查其中 1% 的簇。Deep-1B 上的基线结果未列出,因为它们均超过 12 小时的时间限制。列名依次为数据集、方法、簇数 $k$、时间(秒)、召回率和 WCSS。来源:原论文第 3 页。
3.1.3 面向查询处理的数据重排
传统内存或磁盘 IVF 布局通常将多个簇保存在一个大型二进制文件中。查询引擎从该文件读取选中的簇。文件中的簇顺序,以及每个簇内部的向量顺序,通常都是任意的。原因是 RAM 和 SSD 支持高效随机访问,对物理排列顺序并不敏感。然而,将这一布局和访问方式直接用于云对象存储,会产生两个问题。
第一,云服务商按请求次数计费。若对每个目标簇分别发起 Range-GET 请求,成本可能难以承受。高召回率查询需要遍历较多簇,这一问题尤其突出。直接的解决办法是把多个目标簇合并到一次请求中,以降低查询成本。但如果目标簇在索引对象中的位置相距很远,合并就会引入大量额外数据。请求体积增大后,总下载延迟也随之增加。
第二,完整下载每个目标簇会产生严重的 I/O 浪费。单个 IVF 簇可能包含数百乃至数千个向量,但对特定查询而言,只有少量向量可能成为最近邻候选。因此,始终下载整个簇会浪费网络带宽、降低吞吐量。对于高并发查询,这一影响更加明显。
为解决这两个问题,我们引入请求合并和范围优化。前者将不同簇的请求合并,后者减少每个簇需要传输的数据量。第 3.2.3 节和第 3.2.2 节分别介绍这两种查询机制。本节则介绍支持它们的索引设计,重点讨论簇间和簇内数据重排。
簇间重排。 为有效合并请求,需要调整 IVF 对象中的簇顺序,让可能被一同访问的簇彼此靠近。IVF 根据查询向量与各簇质心的距离选择目标簇。直观上,质心相近的簇更容易同时被某次查询选中,因此应在 IVF 对象中将它们放在相邻位置。
在没有查询工作负载先验信息的情况下,我们仅根据质心确定簇顺序。目标是最小化相邻簇质心之间的距离总和。我们将其建模为最小权重哈密顿路径问题:每个顶点代表一个簇;边的权重为对应质心之间的欧氏距离;路径恰好访问每个顶点一次。随后,在欧氏距离度量下寻找近似最短的哈密顿路径。
最小哈密顿路径问题是 NP 难问题,簇数较大时无法实际求出精确解。已知最好的经典动态规划精确算法,时间复杂度为 $O(n^2 2^n)$ [28],其中 $n$ 是顶点数,也就是簇数。由于边权满足三角不等式,可以采用多项式时间的近似算法,获得质量较高的结果。
我们选用两种基础算法:最近邻启发式算法,其最坏情况下的近似比为 $O(\log n)$ [54];最小生成树倍增算法(MST-doubling),其近似比为 2 [35]。两者都需要先计算距离矩阵。对于 $d$ 维向量,总时间复杂度为 $O(n^2d)$。更先进的算法可以提供更紧的理论界,例如文献 [5, 68],但会引入较大的计算开销,影响索引构建效率。
我们还将空间填充曲线作为对比方法,具体包括 Hilbert 曲线和 Z-order 曲线 [34, 51, 55]。这些方法在数据排序和最近邻搜索中已有应用 [13, 48]。由于空间填充曲线受到维度灾难的影响,我们先使用主成分分析(Principal Component Analysis,PCA),将高维质心投影到三维子空间,再进行排序。
我们在 6 个百万规模数据集上评估上述 4 种簇重排策略。首先,利用 QGKMeans 构建包含 4,096 个簇的 IVF 索引。生成的质心序列具有任意、随机的初始顺序,我们将其作为基线。随后,对质心应用 4 种重排策略。
为衡量重排质量,我们计算基线和各优化配置的哈密顿路径总长度,即整个簇序列中所有相邻质心的欧氏距离之和。结果见表 2。虽然最小生成树倍增算法具有更好的最坏情况理论近似比,但最近邻启发式算法在所有数据集上都取得了最短路径。空间填充曲线产生的路径则明显更长。因此,RemoteANN 默认使用最近邻启发式算法重排簇。
第 3.2.3 节进一步评估不同簇重排方法对 ANN 查询请求合并的影响,验证缩短哈密顿路径能否改善实际效果。
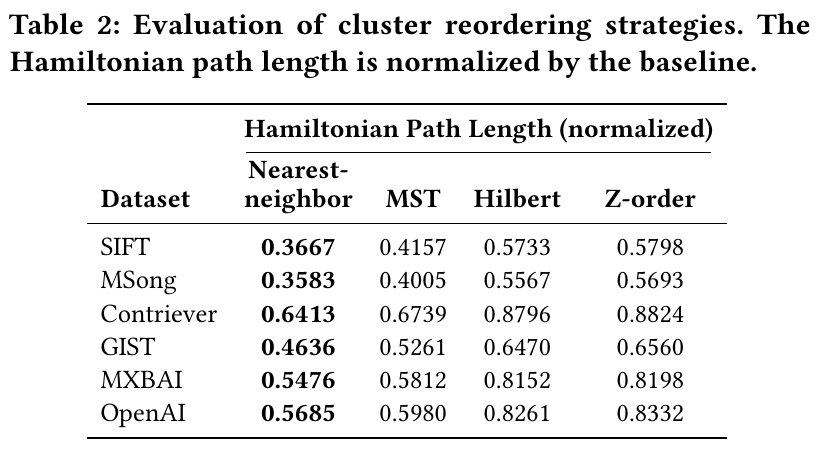
表 2:簇重排策略评估。 哈密顿路径长度以基线结果归一化。各列分别为最近邻启发式、最小生成树倍增、Hilbert 曲线和 Z-order 曲线;数值越小,路径越短。来源:原论文第 4 页。
当大规模数据集包含大量质心时,$O(n^2d)$ 的计算开销较高。为此,我们先对质心进行分区。3 具体做法是采用递归二分 $k$-means,逐步划分质心,直到每个叶节点中的质心数量小于预设上限。然后,在每个分区内独立执行最近邻启发式算法,再按层次树的遍历顺序拼接各子序列,形成全局簇顺序。在 262,144 个质心上,整个重排过程不到 1 分钟,说明该方法可用于大规模数据集。
簇内重排。 范围优化只下载 IVF 簇中包含潜在最近邻候选的特定字节区间。为增强这一优化,我们按照向量到簇质心的欧氏距离,对簇内向量排序。
直观上,当某个簇的质心距离查询较远时,靠近质心的向量不太可能进入最终 top-$k$ 结果,而位于簇外围的向量仍可能相关。按距离排序后,外围向量集中在连续区域中,有望缩小必须下载的字节范围。基于 RaBitQ 的范围优化也能从这种排序中获益,第 3.2.2 节将进一步分析和评估。
3.2 查询阶段
3.2.1 利用 RaBitQ 粗粒度距离估计器进行簇剪枝
如第 3.1 节所述,1 位 RaBitQ 编码驻留在计算节点主存中。系统将这些编码作为粗粒度距离估计器,避免下载不可能为最终 ANN 结果贡献候选向量的簇。我们将这一过程称为簇剪枝。
利用这些编码,系统可以计算目标簇内全部向量的估计距离 $dist_{est}$。RaBitQ 提供无偏估计器,并给出理论误差界 $err$ [25, 27]。因此,每个查询到数据向量的距离,都可以得到解析上界 $dist_{up}$ 和下界 $dist_{lo}$:
$$ dist_{up}=dist_{est}+err,\qquad dist_{lo}=dist_{est}-err. \tag{1} $$
假设预先知道最终 top-$k$ ANN 结果中的最大真实距离,记为 $dist_k$,那么只要某向量满足 $dist_{lo}>dist_k$,就可以立即将其剪除,因为它不可能属于最近的 $k$ 个向量。4
但在从云对象存储读取数据之前,无法确定 $dist_k$。因此,我们采用保守的剪枝阈值。具体而言,在所有候选簇的向量中,计算第 $k$ 小的距离上界,记为 $\mathit{dist}_k^u$。根据定义,$\mathit{dist}k^u\geq dist_k$。如果一个向量的距离下界超过该阈值,即 $dist{lo}>\mathit{dist}_k^u$,它就不可能满足真实 top-$k$ 距离约束。
将这一判断扩展到簇级别:如果某个簇中的所有向量都满足 $dist_{lo}>\mathit{dist}_k^u$,就可以剪除整个簇,完全省去对应的云对象存储请求。$\mathit{dist}k^u$ 和 $dist{lo}$ 都仅依赖 DRAM 中的 RaBitQ 编码,因此这一机制能降低请求成本和网络带宽消耗,同时保持几乎相同的实测召回率。
另一种选择是采用第 $k$ 小的估计距离 $\mathit{dist}_k^e$,作为更激进的剪枝阈值。但 $\mathit{dist}_k^e$ 不保证大于 $dist_k$,可能误删真正的最近邻,导致召回率下降。对于能够接受这一准确率权衡的应用,使用 $\mathit{dist}_k^e$ 可以提高簇剪除比例,进一步降低云端 I/O 成本。
我们使用 6 个百万规模数据集及其指定查询工作负载,评估簇剪枝策略,结果见表 3。该策略显著减少了需要下载的簇数,对高维数据集尤其有效。例如,在 1,536 维的 OpenAI 数据集上,虽然 $n_{\text{probe}}$ 设为 240,查询引擎平均只需从云对象存储读取 13.9 个簇。采用更激进的 $\mathit{dist}_k^e$ 后,簇数还能进一步减少;在 97% 基准召回率下,召回率损失小于 0.5%。
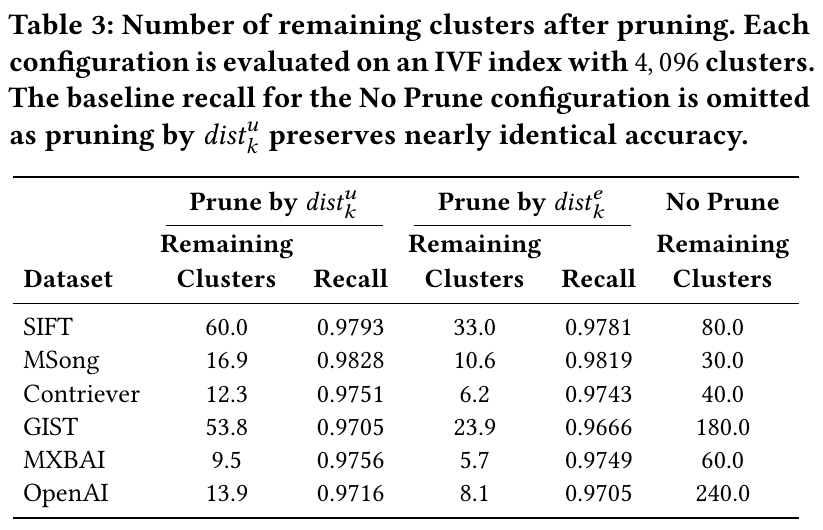
表 3:剪枝后剩余的簇数。 所有配置都在含 4,096 个簇的 IVF 索引上评估。“不剪枝”(No Prune)的基准召回率未列出,因为按 $\mathit{dist}_k^u$ 剪枝后,准确率几乎不变。Remaining Clusters 表示剩余簇数,Recall 表示召回率;两组剪枝列分别采用上界阈值 $\mathit{dist}_k^u$ 和估计值阈值 $\mathit{dist}_k^e$。来源:原论文第 6 页。
此外,在发出 I/O 请求之后,我们还利用 RaBitQ 距离估计器,对尚待评估、尚未返回的簇进行动态剪枝。等待云对象存储响应时,各簇数据会异步到达。查询引擎利用已完成请求更新全局 ANN 结果集,并将已评估向量中的第 $k$ 小距离记为 $dist_k^c$,作为运行时阈值。
随后,用这一更新后的阈值检查仍在途的请求。如果某个待返回簇中所有向量的 $dist_{lo}$ 都超过 $dist_k^c$,就可以安全地跳过该簇。由于这项优化发生在网络请求发出之后,请求总数不会减少,云对象存储费用也不会改变。但它能避免等待部分响应较慢的请求,从而提高端到端查询吞吐量。
我们的剪枝策略与 SPANN 和 SPFresh 中面向查询的动态剪枝具有相似目标 [14, 65],但剪枝标准和数学基础不同。SPANN 和 SPFresh 使用基于比值的启发式方法:若某簇到查询的距离,超过最近簇距离的预设倍数,就将其丢弃。这种方法没有理论保证,还引入一个额外的超参数,增加了配置难度。
RemoteANN 则利用 RaBitQ 估计器的误差界,建立以高概率成立的解析边界。这为剪枝提供了理论依据,也省去了相应的参数调优。
3.2.2 通过范围优化减小请求体积
范围优化的目标是:针对每次查询,只下载各目标簇中包含有效最近邻候选的精确字节区间。如第 3.2.1 节所述,系统使用 RaBitQ 距离估计器生成剪枝阈值。剪枝后保留的向量,通常只占簇内物理地址空间的一部分。
如图 2 所示,对于每个簇,我们动态生成一个范围请求,覆盖包含全部未剪除候选向量的最小连续字节区间。这样可以降低下载总延迟,并节省网络带宽。
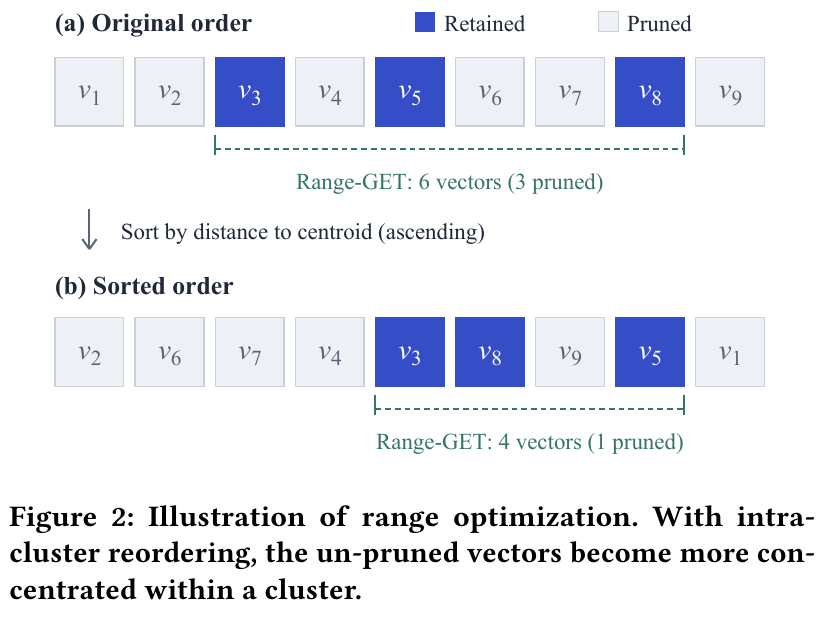
图 2:范围优化示意图。 簇内重排使未被剪除的向量更加集中。Original order 为原始顺序,Sorted order 为排序后的顺序;Retained 为保留向量,Pruned 为剪除向量。按到质心的距离升序排列后,Range-GET 的覆盖范围由 6 个向量缩小为 4 个向量,其中夹带的已剪除向量由 3 个减少为 1 个。来源:原论文第 6 页。
第 3.1.3 节介绍了按向量到质心的距离进行簇内排序。下面进一步分析,这种排序为什么能增强范围优化。RaBitQ [25, 27] 将两个向量之间的距离估计,转换为两个归一化向量的内积估计:
$$ \begin{aligned} |\mathbf{o}_r-\mathbf{q}_r|^2 &=|(\mathbf{o}_r-\mathbf{c})-(\mathbf{q}_r-\mathbf{c})|^2\ &=|\mathbf{o}_r-\mathbf{c}|^2+|\mathbf{q}_r-\mathbf{c}|^2\ &\quad-2|\mathbf{o}_r-\mathbf{c}| \cdot|\mathbf{q}_r-\mathbf{c}| \cdot\langle\mathbf{o},\mathbf{q}\rangle. \end{aligned} \tag{2} $$
其中,$\mathbf{o}_r$ 和 $\mathbf{q}_r$ 分别为原始数据向量和查询向量,$\mathbf{c}$ 为归一化所用的质心。归一化后的单位向量定义为:
$$ \mathbf{o}:=\frac{\mathbf{o}_r-\mathbf{c}} {|\mathbf{o}_r-\mathbf{c}|},\qquad \mathbf{q}:=\frac{\mathbf{q}_r-\mathbf{c}} {|\mathbf{q}_r-\mathbf{c}|}. $$
在 IVF 索引中,簇内数据向量以该簇质心为中心进行归一化。查询时,范数 $|\mathbf{o}_r-\mathbf{c}|$ 和 $|\mathbf{q}_r-\mathbf{c}|$ 采用精确计算。RaBitQ 则对内积 $\langle\mathbf{o},\mathbf{q}\rangle$ 提供无偏估计,并给出解析误差界。
因此,平方欧氏距离的估计误差,等于内积估计误差乘以下列因子:
$$ 2|\mathbf{o}_r-\mathbf{c}|\cdot|\mathbf{q}_r-\mathbf{c}|. $$
对于固定查询和固定簇,$|\mathbf{q}_r-\mathbf{c}|$ 保持不变。向量到质心的距离 $|\mathbf{o}_r-\mathbf{c}|$ 越大,内积估计误差就被放大得越明显。因此,离质心更远的向量具有更宽松的距离误差界,也更难剪除。这意味着,距离质心越远,距离估计误差也越大。
考虑同一簇内的两个数据向量。即使它们到查询的真实距离相近,离质心更远的那个向量,也会得到更宽松的距离下界 $dist_{lo}$,因此更难被安全剪除。按照到质心的距离排序,可以将这些难以剪除的向量集中到数据布局的同一区域。这种局部性使范围优化能够进一步减少从云对象存储读取的字节数。
表 4 比较了不同簇内布局下的范围优化效果。与关闭范围优化相比,启用后下载数据量至少减少 44%。簇内重排进一步扩大了这一降幅。各数据集上持续出现的收益,验证了上述分析,以及第 3.1.3 节所述簇内重排方法的有效性。
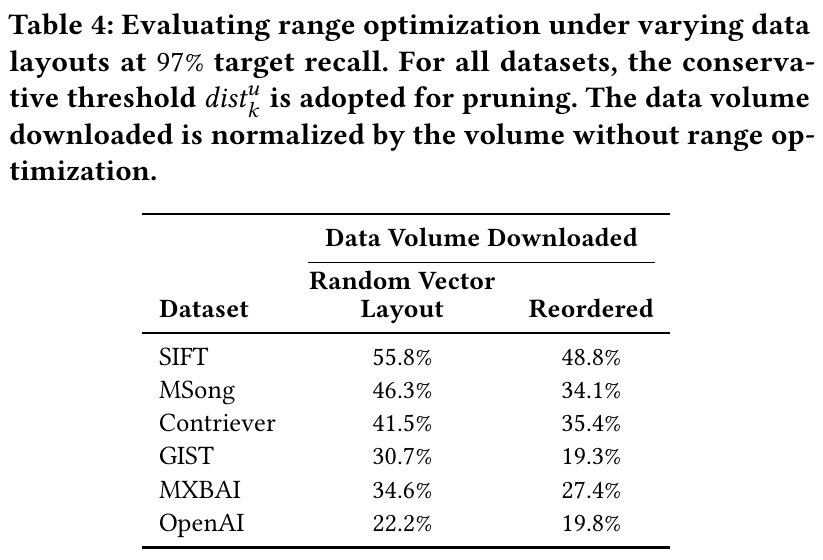
表 4:不同数据布局下的范围优化效果,目标召回率为 97%。 所有数据集均采用保守阈值 $\mathit{dist}_k^u$ 剪枝。下载数据量以关闭范围优化时的数据量归一化。Random Vector Layout 为随机向量布局,Reordered 为重排后的布局;百分比表示剩余下载量,而非减少比例。来源:原论文第 7 页。
3.2.3 通过请求合并降低成本
执行簇剪枝和范围优化后,只需读取未剪除簇中的目标字节区间。如第 3.1.3 节所述,为每个簇分别发起 I/O 请求会增加查询成本。因此,如果多个请求对应的字节区间在索引对象中彼此靠近,我们就将它们合并为一个请求。这就是请求合并策略。
参考 Databricks [53] 和 Lance [46] 等系统,我们使用固定的合并阈值。任何合并后请求的体积都不能超过该阈值;单个请求已经超过阈值时,不参与合并。这样可以避免请求携带过多数据,损害端到端查询吞吐量。
根据实验环境中的实测结果,我们将合并后请求的最大体积设为 600 KB,以平衡每次请求的延迟开销和额外数据传输。对于能够容忍较高延迟的工作负载,可以提高阈值,进一步减少请求次数。图 3 展示了从云对象存储读取目标字节区间的过程。部分请求的位置相近,因此可以合并读取。
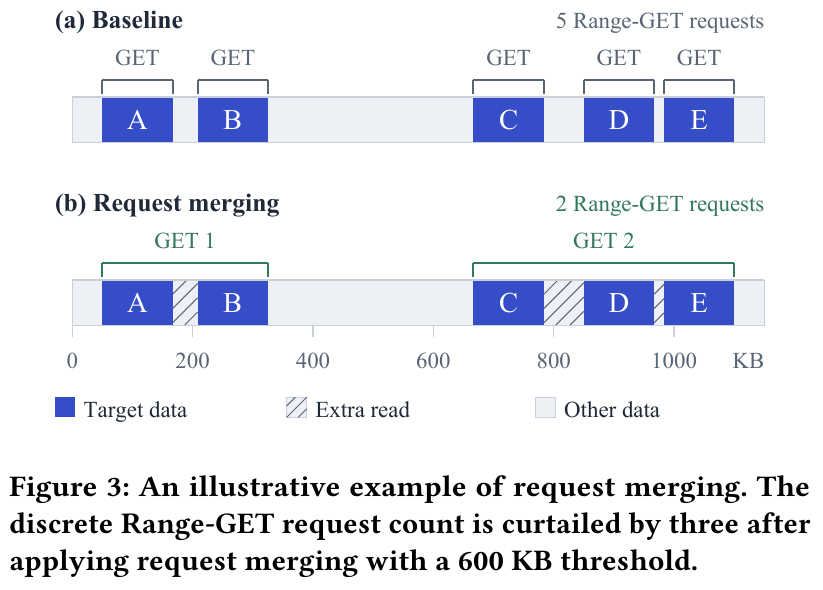
图 3:请求合并示例。 使用 600 KB 的合并阈值后,独立 Range-GET 请求由 5 个减少为 2 个,共减少 3 个。Baseline 为基线,Request merging 为请求合并;Target data 为目标数据,Extra read 为合并时额外读取的数据,Other data 为其他数据。横轴为对象中的字节偏移,单位为 KB。来源:原论文第 7 页。
我们设计了动态规划(Dynamic Programming,DP)算法,在固定阈值 $T$ 下合并请求。优化目标按优先级排列:先最小化请求数;在请求数同样最少的方案中,再最小化总下载字节数。
首先,按起始偏移对所有候选请求排序。设 $L(i,j)$ 表示覆盖请求 $i,\dots,j$ 所需的字节跨度。当 $L(i,j)\leq T$ 时,这些请求可以构成一个有效的合并组。定义:
$$ D[j]=(K_j,B_j), $$
表示前 $j$ 个请求的最优结果。其中,$K_j$ 为请求数,$B_j$ 为下载字节数。以 $D[0]=(0,0)$ 为初始状态,计算:
$$ D[j]= \min_{\substack{1\leq i\leq j\L(i,j)\leq T}} \bigl(K_{i-1}+1,;B_{i-1}+L(i,j)\bigr). $$
这里的比较先以请求数为准,再比较下载字节数。每次状态转移都将请求 $i,\dots,j$ 视为最后一个合并组。记录选中的起始下标后,从 $D[N]$ 回溯,即可恢复分组。
下面给出最优性的证明概要。体积超过 $T$ 的请求不参与动态规划,合并完成后再作为独立请求加入。它们对请求数和下载量的贡献固定,因此不会影响最优性。
对于剩余的第一个请求,$D[1]$ 显然最优。假设 $D[0],\dots,D[j-1]$ 都已最优。某个处理前 $j$ 个请求的最优方案,设其最后一个合并组为 $i,\dots,j$。根据归纳假设,$D[i-1]$ 能以不更多的请求数覆盖前面的请求;如果请求数相同,下载字节数也不会更多。
动态规划考虑了所有有效的起始下标 $i$,因此一定能够找到至少与该最优方案同样好的结果。于是,$D[j]$ 也最优。由数学归纳法可知,$D[N]$ 最小化了总请求数,并在请求数最少的所有连续分组方案中,最小化总下载字节数。
簇在索引对象中的局部性,直接影响请求合并效果。如果簇顺序随机,某次查询的目标簇可能分散在整个索引对象中,合并效果就会较差。第 3.1.3 节比较了 4 种簇间重排策略,发现最近邻启发式算法在所有测试数据集上都取得了最短哈密顿路径。
为验证这一选择,我们评估了 ANN 搜索中的端到端请求合并效果。5 如表 5 所示,最近邻启发式算法在大多数数据集上取得了最少的总请求数。这说明,哈密顿路径长度可作为有效的替代指标,衡量簇局部性对下游 IVF ANN 搜索的帮助。
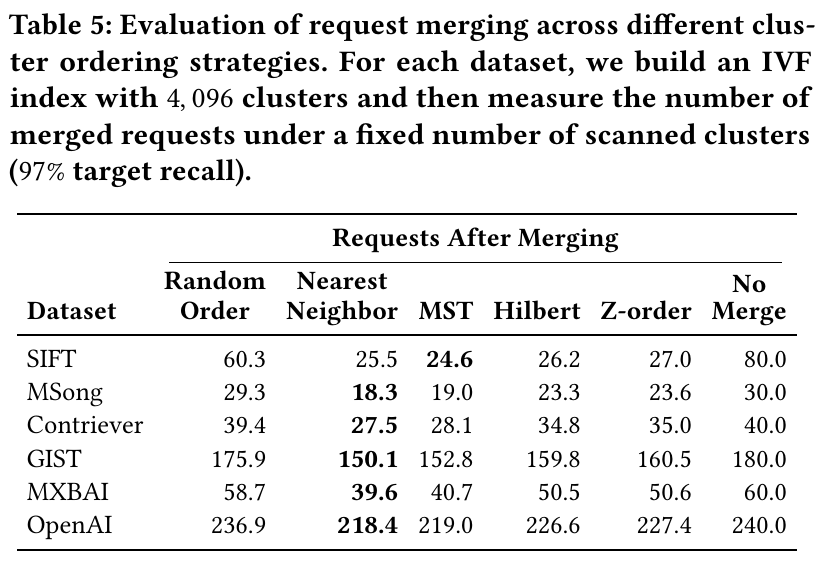
表 5:不同簇排序策略下的请求合并效果。 对每个数据集构建包含 4,096 个簇的 IVF 索引。固定扫描簇数,使目标召回率达到 97%,再测量合并后的请求数。Random Order 为随机顺序,Nearest Neighbor 为最近邻启发式,MST 为最小生成树倍增,Hilbert 和 Z-order 为两种空间填充曲线,No Merge 为不合并。来源:原论文第 7 页。
3.2.4 利用本地 SSD 缓存热点簇
如果计算节点配有本地 NVMe SSD,就可以将其作为云对象存储数据的中间缓存。6 查询需要某个簇时,系统先检查本地 SSD 缓存。如果命中,就完全省去从云对象存储下载数据的过程。下面介绍 RemoteANN 的缓存设计。
缓存以簇为单位,与查询中的空间访问模式保持一致。为减少物理碎片,每个簇都填充到标准 4 KB 页的边界。全部数据存放在一个预先分配的后备文件中,文件以 O_DIRECT 标志打开,绕过操作系统的页缓存。
后备文件以 4 KB 为单位分配空间,使用采用最佳适配策略的空闲区间映射进行管理。簇被淘汰后,系统动态合并相邻的空闲区间。在实测比较多种缓存策略后,我们采用结合两种机制的缓存引擎:借鉴 TinyLFU 的准入策略 [20],以及带老化机制的最不经常使用(LFU)替换策略。系统为每个簇维护访问频率计数,并定期将计数减半。
为提高 I/O 并发度,我们利用高性能 io_uring 接口异步读写缓存。读取操作先汇集、批处理,再异步提交。缓存写入则完全脱离查询执行的关键路径,交由后台工作线程处理。
簇级缓存与范围优化之间存在固有冲突。前者按完整簇管理数据,后者只读取簇内最小的必要字节区间,以节省带宽。为协调两者,我们引入自适应回退阈值。
启用本地 NVMe 缓存时,系统使用预设比例 $\gamma$,例如 $\gamma=0.8$,判断是否采用范围优化。只有当优化后的区间小于簇总体积的 $\gamma$ 倍时,才执行范围请求。否则,系统下载完整簇,用少量额外网络传输换取本地 SSD 缓存填充,让后续查询受益。
3.3 小结
算法 1 和算法 2 分别总结了索引构建和查询流程。算法 1 描述离线索引构建:利用高效的 QGKMeans 加速 IVF 聚类,并通过簇内和簇间重排改善数据局部性。
算法 2 展示查询引擎如何在运行时使用这一布局。依靠本地内存中的 1 位 RaBitQ 编码,查询引擎动态执行簇剪枝、范围优化、请求合并和缓存操作。两部分共同构成专门面向云对象存储的算法与系统协同设计。
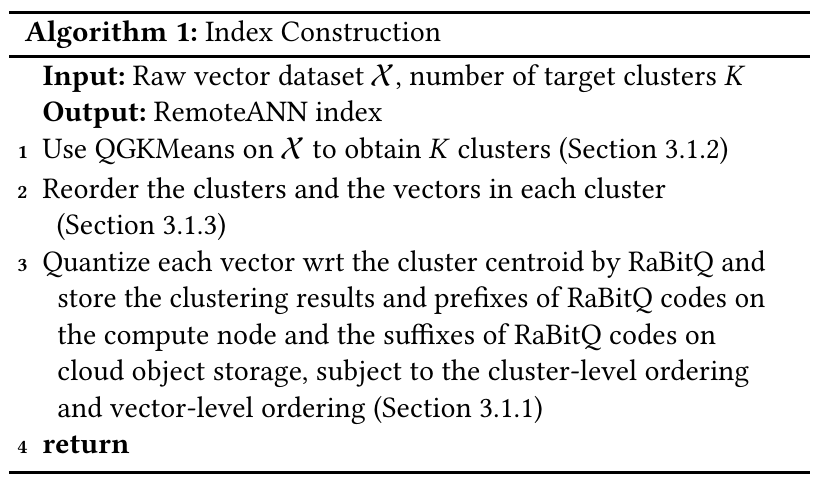
算法 1:索引构建。 来源:原论文第 8 页。
输入:原始向量数据集 $\mathcal{X}$,目标簇数 $K$。输出:RemoteANN 索引。
- 对 $\mathcal{X}$ 执行 QGKMeans,得到 $K$ 个簇,见第 3.1.2 节。
- 重排各个簇,以及每个簇内的向量,见第 3.1.3 节。
- 以簇质心为参照,用 RaBitQ 量化每个向量。按照簇级和向量级排序,将聚类结果与 RaBitQ 编码前缀存放在计算节点,将编码后缀存放在云对象存储,见第 3.1.1 节。
- 返回。
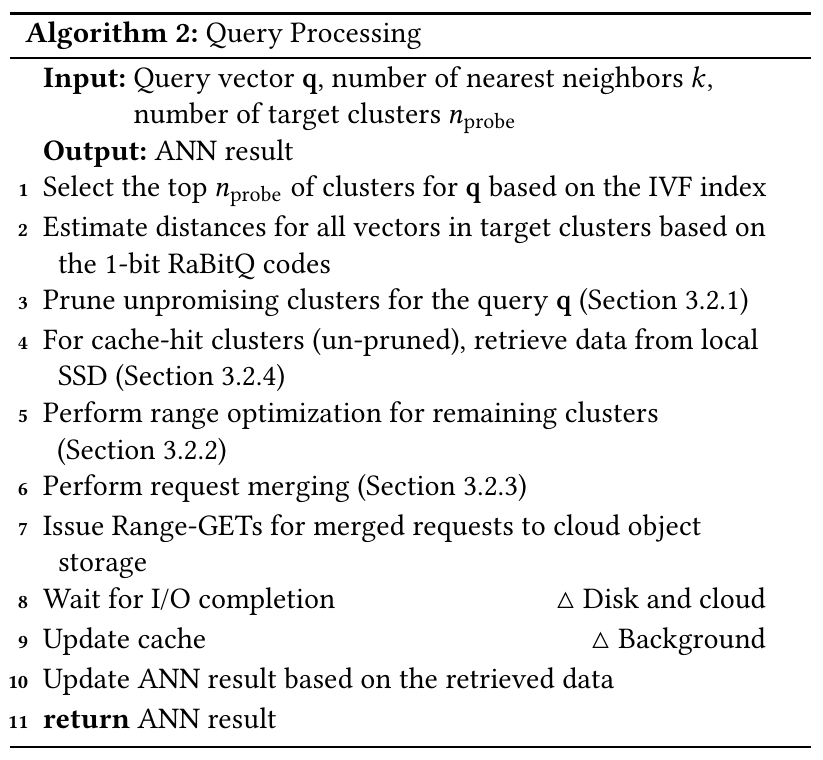
算法 2:查询处理。 来源:原论文第 8 页。
输入:查询向量 $\mathbf{q}$、最近邻数量 $k$、目标簇数 $n_{\text{probe}}$。输出:ANN 结果。
- 根据 IVF 索引,为 $\mathbf{q}$ 选择最接近的 $n_{\text{probe}}$ 个簇。
- 利用 1 位 RaBitQ 编码,估计目标簇内全部向量的距离。
- 剪除不可能为查询 $\mathbf{q}$ 提供结果的簇,见第 3.2.1 节。
- 对于未被剪除且缓存命中的簇,从本地 SSD 读取数据,见第 3.2.4 节。
- 对其余簇执行范围优化,见第 3.2.2 节。
- 执行请求合并,见第 3.2.3 节。
- 向云对象存储发出合并后的 Range-GET 请求。
- 等待磁盘和云端 I/O 完成。
- 在后台更新缓存。
- 根据取回的数据更新 ANN 结果。
- 返回 ANN 结果。
4 实验
本节使用不同维度、不同规模的现代向量数据集,评估 RemoteANN 和基线方法。同时,通过消融实验,分别分析所提出策略的效果。
4.1 实验设置
数据集。 我们采用 6 个常用的百万规模数据集:SIFT、MSong、Contriever、GIST、MXBAI 和 OpenAI。还使用更大的 Cohere 和 Deep-1B 数据集测试可扩展性。这些数据集覆盖不同的向量维度、数量和类型,已广泛用于现有 ANN 算法及库的研究和基准测试 [8, 18, 44, 56]。
对于自带评估划分的数据集,我们采用默认查询工作负载。对于没有明确查询划分的数据集,从主数据集中抽取 1,000 个向量作为评估查询。详细统计见表 6。
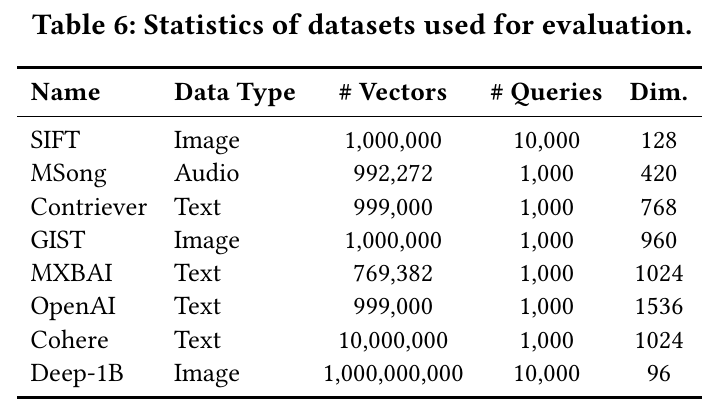
表 6:评估数据集的统计信息。 Name 为数据集名称,Data Type 为数据类型,# Vectors 为向量数,# Queries 为查询数,Dim. 为维度。Image、Audio 和 Text 分别表示图像、音频和文本。来源:原论文第 9 页。
基线。 我们将 RemoteANN 与两种有代表性的基线进行比较。
Lance-RQ。Lance [46] 是支持云对象存储向量搜索的开源存储引擎。我们使用 Lance v13.0.0 的 IVF-RQ 索引,并将其记为 Lance-RQ。该索引结合 IVF 分区和 RaBitQ 量化。为与 RemoteANN 的数据放置方式一致,查询期间将索引元数据和每维 1 位的 RaBitQ 编码保存在 EC2 实例的 DRAM 中;全精度向量则保存在云对象存储中,用于重排候选结果。
RemoteSPANN。我们选择 SPANN [14] 作为第二种基线。原因是其动态扩展 SPFresh [65] 已被 Turbopuffer [61] 采用,而后者是专门面向对象存储的商业向量数据库。但 Turbopuffer 的实现不开源,难以监测其内部执行过程,也无法控制内部配置。
本文聚焦静态 ANN 工作负载,因此我们基于开源 SPANN 实现构建 RemoteSPANN。具体做法是,将其本地磁盘 I/O 后端替换为与 RemoteANN 相同的云对象存储层,以便开展受控、公平的比较。
系统配置。 向量搜索分为离线索引构建和在线查询处理两个阶段。常见部署方式是:使用高性能、资源充足的机器构建索引,再使用成本较低的轻量计算节点提供在线查询服务。
遵循这一模式,索引构建运行在本地服务器上。服务器配有 Intel Xeon Gold 6418H@4.0GHz CPU,采用 Sapphire Rapids 架构,拥有 24 个核心、48 个线程,以及 1 TB DRAM。7 云端评估主要使用 Amazon Web Services(AWS)。
索引构建完成后,将需要驻留内存的路由结构部署到 Amazon EC2 计算实例,其余数据保存在与计算节点同一区域的 Amazon S3 存储桶中。除非另有说明,实验均使用 m5dn.2xlarge 实例,配置为 8 个虚拟 CPU、32 GB DRAM、300 GB 本地 NVMe SSD,以及最高 25 Gbps 的网络带宽。8
RemoteANN 和 RemoteSPANN 均以原生 C++ 实现。云对象存储 I/O 由基于官方 AWS SDK 构建的下载模块管理。离线索引流水线在 Ubuntu 22.04 LTS 上使用 GCC 14.3.0 编译;在线查询引擎在 AWS EC2 提供的 Ubuntu 26.04 LTS 上使用 GCC 15.2.0 编译。Lance-RQ 使用官方 Python 发行版,该版本原生支持索引、查询和远程 I/O。
参数设置。 索引构建期间,RemoteANN 对所有数据集使用每维 9 位的 RaBitQ 量化。IVF 簇数依据 Faiss 的经验建议设置,具体见表 1。Lance-RQ 使用相同的 IVF 簇数,其余索引参数保留默认值。RemoteSPANN 使用开源 SPANN 实现的默认索引参数 [14]。
查询期间,我们改变 RemoteANN 和 RemoteSPANN 的探测簇数 $n_{\text{probe}}$,评估吞吐量与准确率之间的权衡。对于 Lance-RQ,遵循推荐的调参流程,同时调整 $n_{\text{probe}}$ 和控制候选重排数量的 refine_factor 参数。
refine_factor 的取值集合为 ${5,10,20}$;对于 Deep-1B,扩展为 ${5,10,20,40,80}$。我们报告各配置的吞吐量与准确率帕累托前沿,即无法在不损失其中一项的情况下进一步改善另一项的配置集合。
查询性能指标。 按照已有索引基准 [8, 14, 56],使用吞吐量和端到端延迟衡量查询效率。其中,吞吐量以每秒查询数(Queries Per Second,QPS)表示;搜索准确率通过召回率衡量。本节全部实验都检索 top-$k$ 最近邻,并将 $k$ 固定为 10。
4.2 实验结果
4.2.1 性能评估
本节介绍端到端搜索性能、远程 I/O 统计、索引构建时间和内存占用。
端到端查询性能。 我们系统地遍历查询参数,在并发度为 1、4 和 16 时,评估吞吐量与召回率之间的权衡。图 4 展示了相应的 QPS 与召回率曲线。曲线越靠近右上角,性能越好。表 7 报告目标召回率为 97% 时的延迟。9
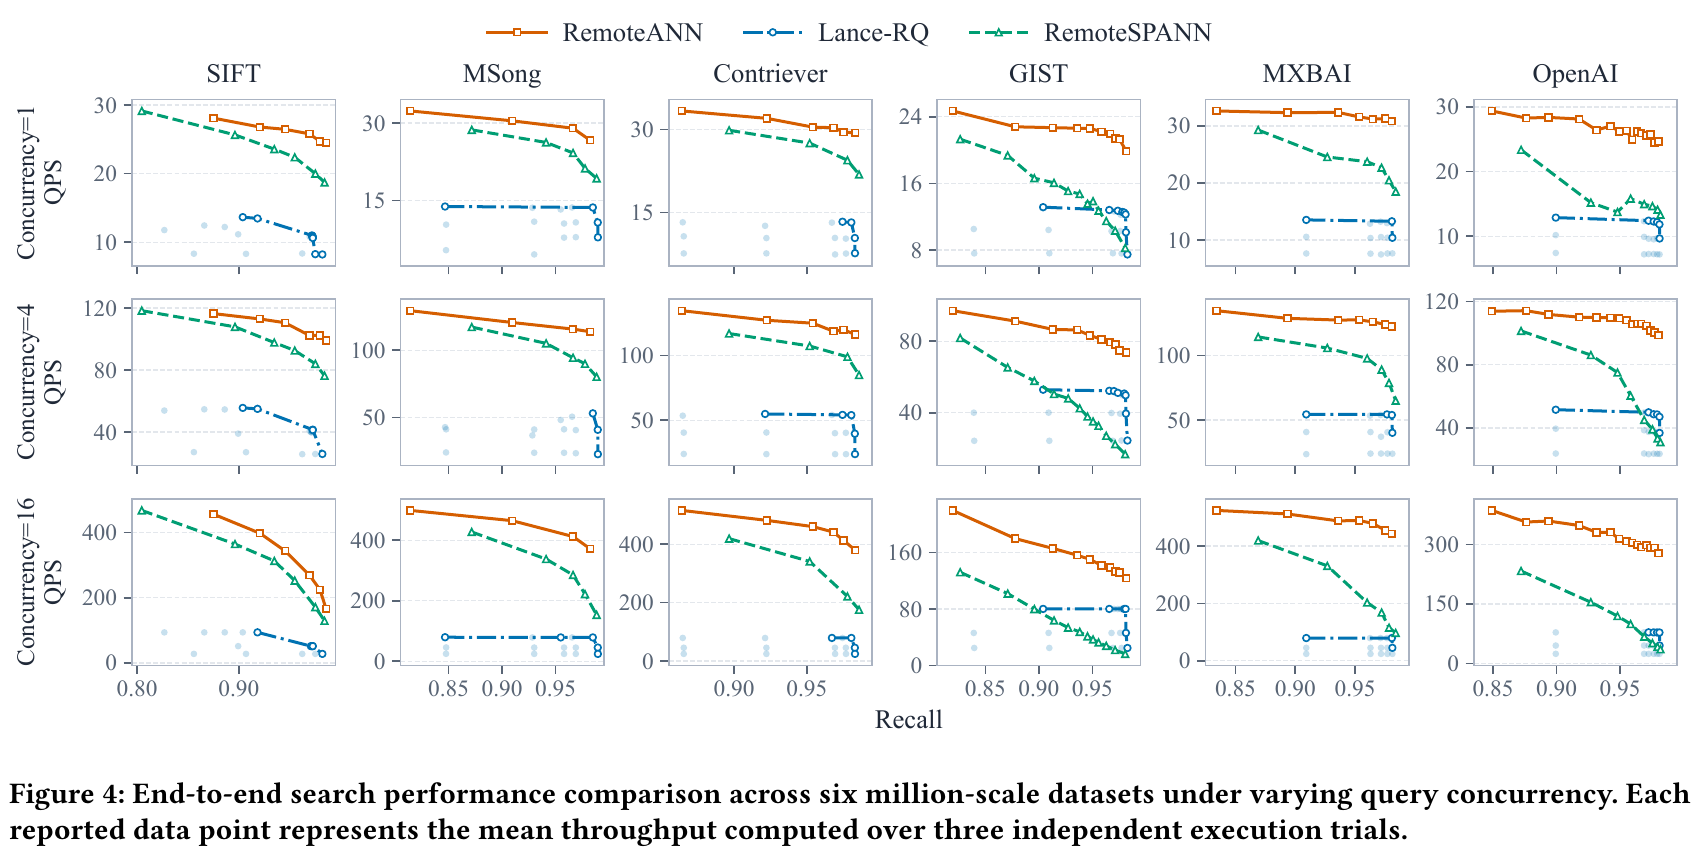
图 4:6 个百万规模数据集在不同查询并发度下的端到端搜索性能。 每个数据点表示 3 次独立实验的平均吞吐量。横轴 Recall 为召回率,纵轴 QPS 为每秒查询数;3 行分别对应并发度 1、4 和 16,6 列对应 SIFT、MSong、Contriever、GIST、MXBAI 和 OpenAI。来源:原论文第 10 页。
主要观察如下。
- 在所有测试数据集和并发度下,RemoteANN 的吞吐量与召回率权衡都优于 Lance-RQ 和 RemoteSPANN。随着并发度提高,它的吞吐量优势通常更加明显,尤其是在 Contriever、MXBAI 和 OpenAI 上。
- 当目标召回率为 97% 时,RemoteANN 在全部 18 种配置中都取得了最低的中位延迟 $p_{50}$,并在其中 16 种配置中取得最低的尾延迟 $p_{95}$。Lance-RQ 的 $p_{50}$ 为 RemoteANN 的 1.47 至 5.57 倍,$p_{95}$ 为其 1.19 至 5.15 倍。尾延迟的例外出现在 MSong 数据集上:并发度为 1 和 4 时,RemoteSPANN 的 $p_{95}$ 略低。
- QPS 与召回率曲线存在波动,不像内存 ANN 索引的曲线通常那样平滑 [8, 18, 26, 31]。这种波动与云对象存储 I/O 性能的变化相符,已有研究也报告了类似现象 [19]。
- RemoteSPANN 在多个数据集上优于 Lance-RQ,说明它在这些场景中具有竞争力,也支持将其作为补充基线。
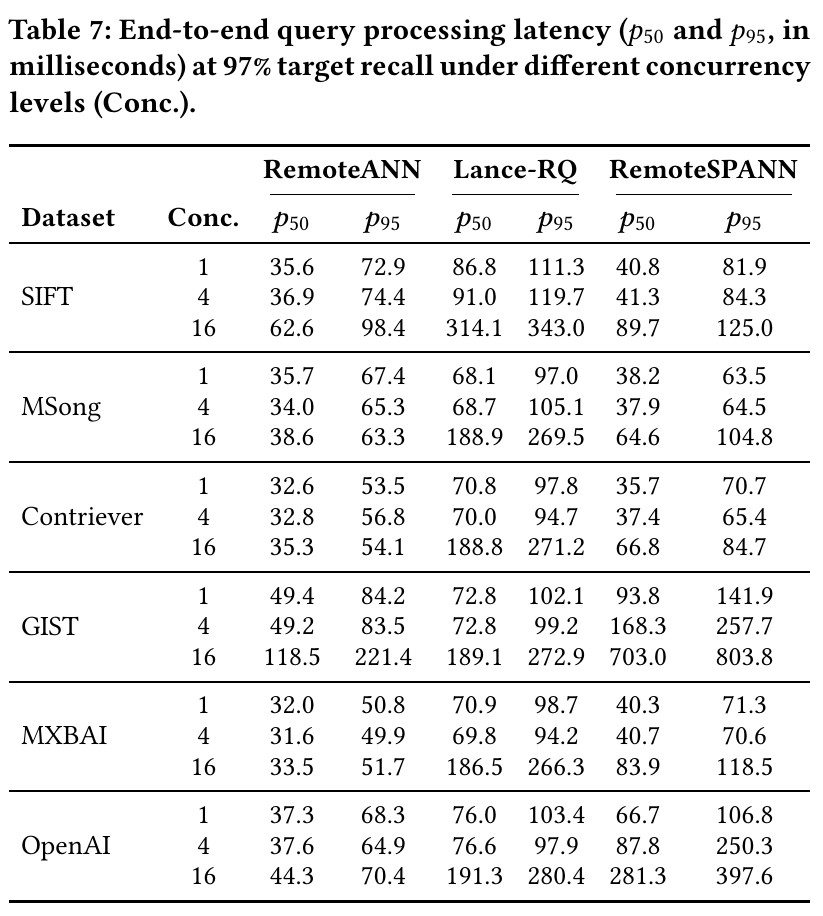
表 7:目标召回率为 97% 时,不同并发度下的端到端查询延迟。 单位为毫秒。Conc. 为并发度,$p_{50}$ 和 $p_{95}$ 分别为第 50 百分位和第 95 百分位延迟。来源:原论文第 10 页。
云端 I/O 统计。 表 8 报告在召回率至少为 97% 的约束下,各方法达到的最小平均 Range-GET 请求数。RemoteANN 在全部测试数据集上都发出了最少的独立请求,直接降低了按请求次数计费的云对象存储成本。
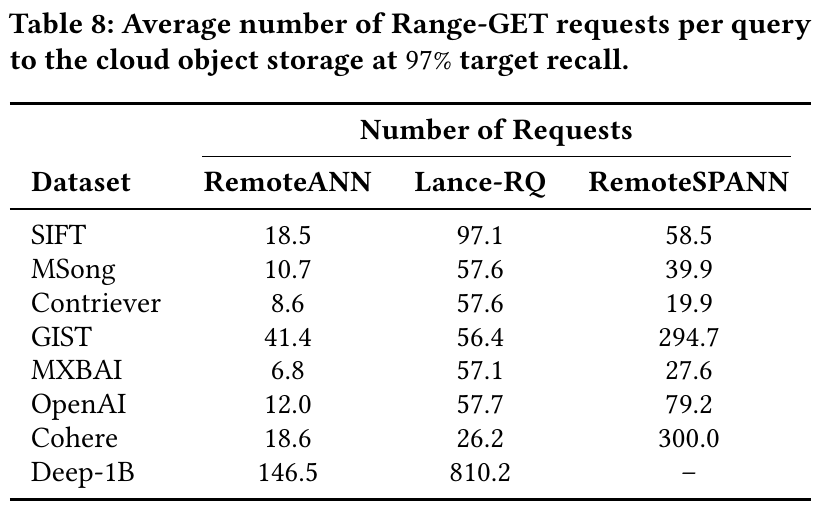
表 8:目标召回率为 97% 时,每次查询向云对象存储发出的平均 Range-GET 请求数。 Number of Requests 为请求数;各列分别对应 RemoteANN、Lance-RQ 和 RemoteSPANN。来源:原论文第 10 页。
索引构建时间与内存占用。 我们评估各方法在所有数据集上的索引构建时间和稳态内存消耗,结果见表 9。10
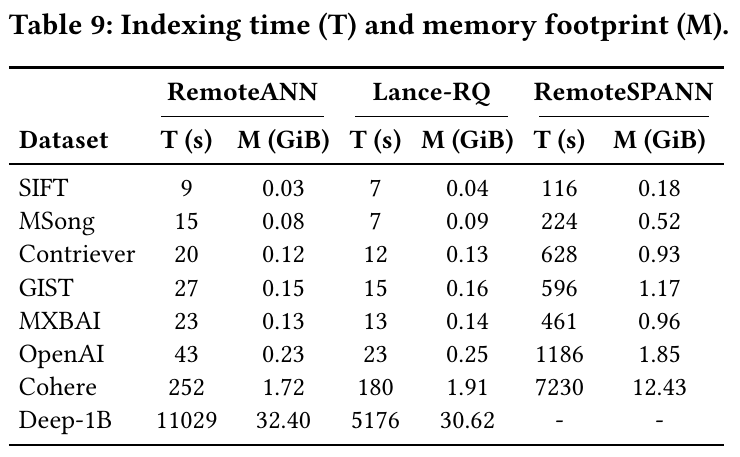
表 9:索引构建时间(T)与内存占用(M)。 T 的单位为秒,M 的单位为 GiB。未提供结果的位置保留原表的横线。来源:原论文第 11 页。
在 QGKMeans 的帮助下,RemoteANN 相对于 RemoteSPANN 的索引构建加速比最高达到 31,相关聚类结果见表 1。虽然 RemoteANN 的构建时间长于 Lance-RQ,但两者仍处于同一数量级。
额外构建成本主要来自两方面。第一,RemoteANN 使用扁平 $k$-means,而 Lance-RQ 默认使用层次 $k$-means。11 第二,RemoteANN 执行了额外处理,以改善查询性能。这些构建成本是一次性投入,可以在后续查询中获得回报。考虑到查询性能的明显提升,我们认为这一权衡值得采用。
在第 4.1 节的数据放置设置下,RemoteANN 与 Lance-RQ 的内存消耗相近,而 RemoteSPANN 的内存消耗明显更大。差异主要来自内存中的数据结构。沿用 SPANN [14] 的设计,RemoteSPANN 在 DRAM 中保存簇质心和路由图。受簇大小限制和向量复制的影响,它生成了大量簇。默认配置下,质心数量约为数据集向量数的 20%。
相比之下,RemoteANN 和 Lance-RQ 的内存主要用于保存紧凑的 1 位 RaBitQ 编码,因此内存占用小得多。
4.2.2 可扩展性评估
我们使用 Cohere 和 Deep-1B 数据集,验证 RemoteANN 和基线方法的可扩展性。相应的索引构建参数,即 IVF 簇数,见表 1。对于 Deep-1B,我们使用 AWS EC2 c5n.4xlarge 计算节点,以满足更高的运行时内存需求。
图 5 给出端到端 QPS 与召回率曲线;表 8 和表 9 分别汇总云对象存储 I/O、索引构建时间和内存占用。Deep-1B 上未报告 RemoteSPANN 的结果,因为 SPANN 的索引构建超过了 24 小时的限制。
与百万规模数据集上的趋势一致,在 Cohere 和 Deep-1B 上,RemoteANN 在所有查询并发度下都优于参与评估的基线。稳定的搜索性能验证了该方法的可扩展性和稳健性。此外,RemoteANN 在云端 I/O 指标上也保持明显优势,与百万规模实验结果一致。
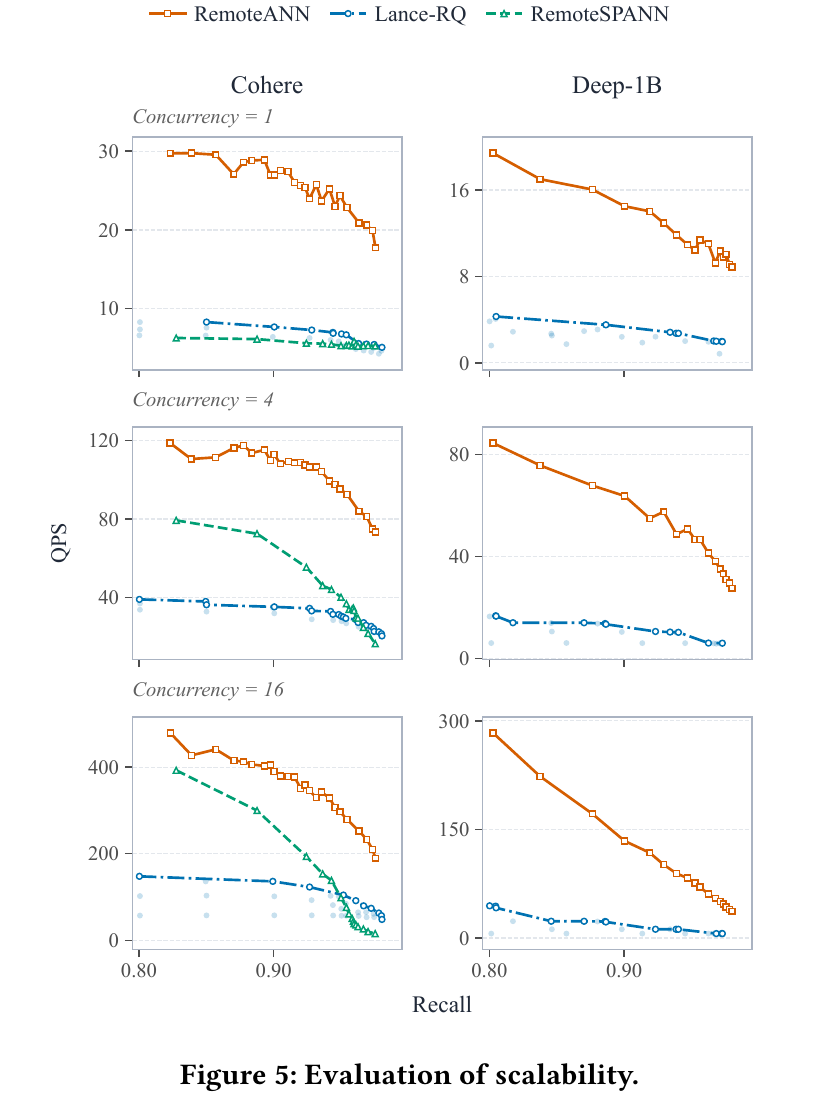
图 5:可扩展性评估。 两列分别为 Cohere 和 Deep-1B;3 行对应并发度 1、4 和 16。横轴 Recall 为召回率,纵轴 QPS 为每秒查询数。来源:原论文第 11 页。
4.2.3 消融实验
我们在 Contriever 和 OpenAI 数据集上开展消融实验,评估各查询优化组件的独立贡献。首先移除第 3.2 节的全部查询优化,建立朴素基线。随后依次加入簇剪枝、范围优化和请求合并,逐步恢复完整的 RemoteANN 框架。结果见图 6。
簇剪枝和范围优化都能在保持检索准确率的同时,显著提高查询吞吐量。加入请求合并后,由于下载数据量增加,高并发场景下的吞吐量略有下降,但云端 API 运行成本得到降低。例如,根据表 3 和表 8,请求数在 Contriever 上减少约 30%,在 OpenAI 上减少约 14%。
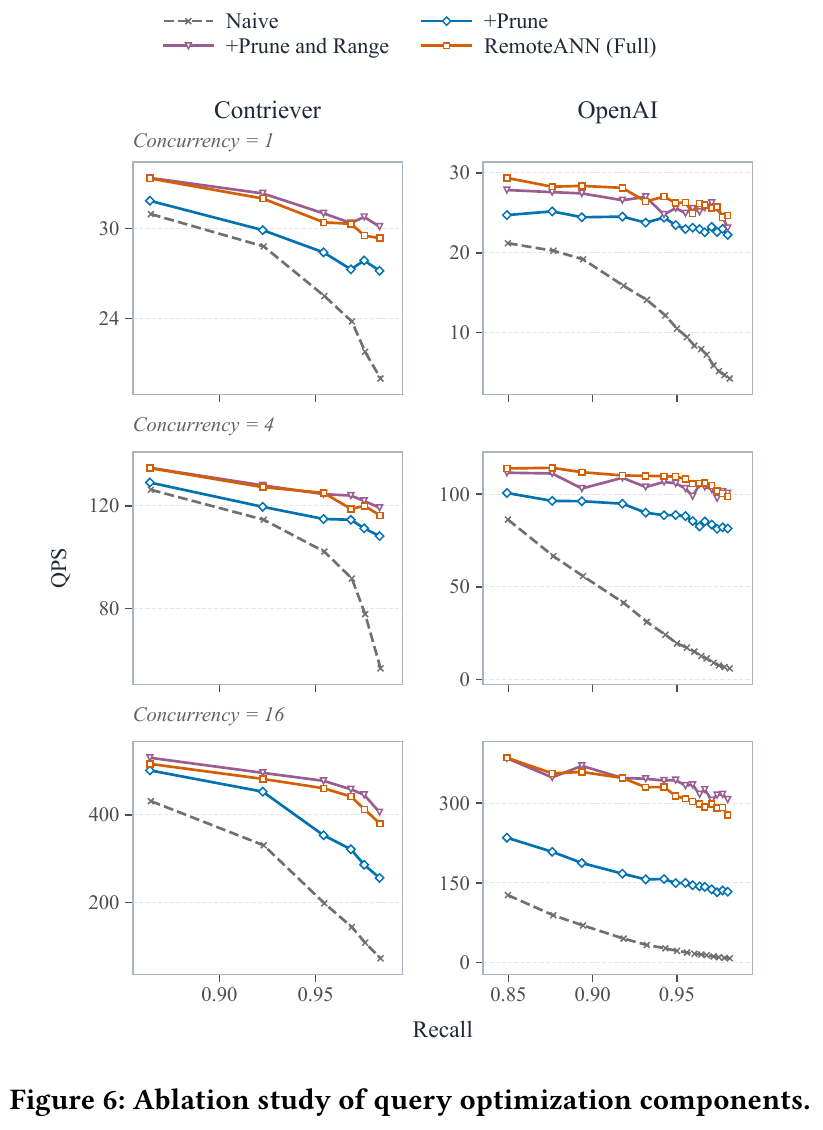
图 6:查询优化组件的消融实验。 Naive 为朴素基线,+Prune 表示加入簇剪枝,+Prune and Range 表示继续加入范围优化,RemoteANN (Full) 为完整版本。两列分别为 Contriever 和 OpenAI,3 行对应并发度 1、4 和 16;横轴为召回率,纵轴为 QPS。来源:原论文第 11 页。
对于第 3.2.4 节介绍的本地 NVMe SSD 缓存,在 Contriever 和 OpenAI 上的查询吞吐量与无缓存基线相当。因此,我们省略重叠的 QPS 与召回率曲线,主要分析缓存命中率。
如表 10 所示,随着缓存容量增加,命中率单调上升。缓存效果也高度依赖查询工作负载的特征。在这些实验中,Contriever 的命中率高于 OpenAI。
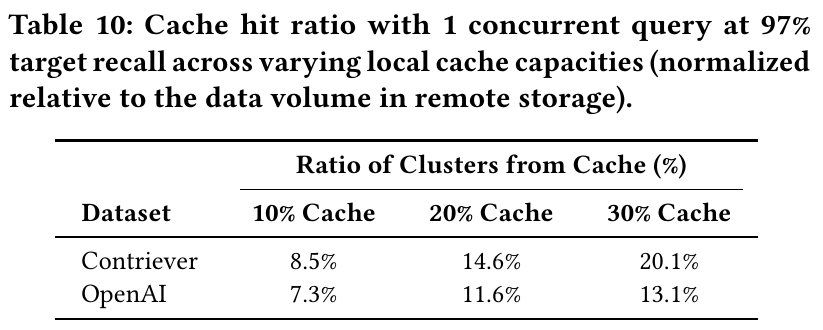
表 10:并发度为 1、目标召回率为 97% 时,不同本地缓存容量下的缓存命中率。 缓存容量按远程存储数据量归一化,分别为 10%、20% 和 30%。表内数值表示从缓存读取的簇所占比例。来源:原论文第 12 页。
最后,我们评估框架的一个变体 RemoteANN-Raw,在表 11 中记为 Raw。该变体将原始数据向量保存在云对象存储中,替代紧凑的 RaBitQ 量化编码,同时保留其他查询优化。
如表 11 所示,它的 QPS 低于标准 RemoteANN,但仍明显高于其他基线。这说明,RemoteANN 相对基线的大部分加速收益,主要来自索引和查询的协同优化。无论底层存储的是量化编码还是原始向量,这些优化都有效。
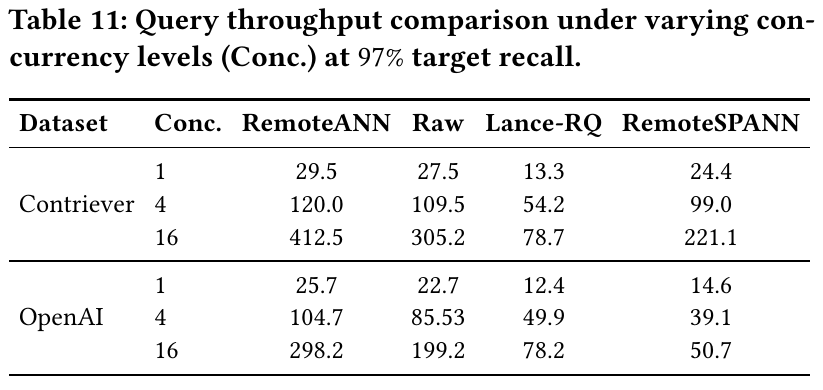
表 11:目标召回率为 97% 时,不同并发度下的查询吞吐量对比。 Conc. 为并发度,各方法列为 QPS;Raw 表示 RemoteANN-Raw。来源:原论文第 12 页。
5 相关工作
近似最近邻搜索索引。 现有 ANN 索引主要包括基于图 [22, 40, 49]、基于量化 [6, 9, 25, 27, 29, 33, 41]、基于哈希 [16, 23, 36, 38, 58, 59]、基于聚类 [14, 65] 和基于树 [7, 11, 15, 32] 的方法。以往研究主要关注内存或磁盘场景,RemoteANN 则专门面向云对象存储,同时设计索引和查询机制。
云对象存储与向量搜索。 受云对象存储的弹性、持久性和成本效益推动,学术界和工业界提出了多种以对象存储为后端的数据管理系统。AnyBlob [19] 探索了云对象存储用于联机分析处理(OLAP)工作负载的潜力,并开发了高性能下载管理器。近期的一项实证研究 [47],比较了两种代表性磁盘 ANN 索引在云对象存储后端上的性能,即 SPANN [14] 和 DiskANN [40]。
工业界也出现了一系列基于云对象存储的向量搜索引擎,包括 Turbopuffer [61]、Amazon S3 Vectors [4]、Lance [46] 和 Databricks [53]。Turbopuffer 与 Amazon S3 Vectors 均采用 SPFresh [65] 作为底层索引,Lance 和 Databricks 则采用 IVF 索引变体。
我们没有将 RemoteANN 与闭源的 Turbopuffer、Amazon S3 Vectors 服务,或完整的 Databricks 平台直接比较。我们评估的是 Lance 的 IVF-RQ 索引,记为 Lance-RQ,以及 RemoteSPANN。这样可以在受控的存储和数据放置条件下,比较有代表性的索引方案,聚焦索引结构与云环境的算法协同设计。
加速 IVF 构建。 近期工作通过引入 ANN 搜索技术,加速 IVF 构建中的 $k$-means 聚类。SuperKMeans [44] 将维度剪枝 [26] 与 PDX 数据布局 [45] 结合,以降低距离计算成本。基于图的方法也能加速这一阶段 [17, 57, 64]。
例如,SeededANN [57] 为质心构建 HNSW 索引,并利用上一轮的分配结果,为后续搜索提供起点。另一类方法则在压缩向量上进行聚类,以降低计算和内存开销 [43]。
输入压缩与质心分配方法属于可独立选择的两个设计维度,理论上可以与 QGKMeans 结合。本文评估聚焦于原始输入向量上的加速,因此不比较与输入压缩组合后的效果。
6 结论与讨论
本文提出了 RemoteANN,一种面向云对象存储协同设计的向量搜索引擎。针对远程存储较高的网络延迟和按请求次数计费的特点,RemoteANN 将 IVF 索引、RaBitQ 量化和注重局部性的数据布局结合。它通过 QGKMeans 加速索引构建,并在查询引擎中组合簇剪枝、范围优化、请求合并和缓存。
在真实数据集上,RemoteANN 的查询吞吐量持续优于所选代表性基线,同时产生更低的存储 API 费用。消融实验进一步验证了查询侧优化的贡献,可扩展性评估则表明,这些收益能够保持到十亿规模。
当前仍有若干限制,也为未来工作指出了方向。首先,RemoteANN 面向静态 IVF 索引。如何在云对象存储上支持高效的增量更新和删除,仍是向量搜索的开放问题。
其次,本文评估预热后的查询场景,即索引元数据已驻留在计算节点内存中。进一步研究冷启动缓解策略,例如由工作负载驱动的预取,有望扩大 RemoteANN 在突发或间歇性工作负载中的适用范围。我们认为,本文提出的协同设计原则,可以为这一领域的后续系统提供通用基础。
参考文献
以下保留原论文的参考文献编号、原文题名及著录信息。参考文献中的访问日期也沿用原文,不表示本次翻译逐一访问了这些资源。
[1] Amazon Web Services. 2026. Amazon EBS. https://aws.amazon.com/ebs/. Accessed: 2026-06-11.
[2] Amazon Web Services. 2026. Amazon EC2. https://aws.amazon.com/pm/ec2/. Accessed: 2026-06-11.
[3] Amazon Web Services. 2026. Amazon S3 - Cloud Object Storage - AWS. https://aws.amazon.com/s3/. Accessed: 2026-06-11.
[4] Amazon Web Services. 2026. Amazon S3 Vectors: Object Storage for Cloud-Native Vector Search. https://aws.amazon.com/s3/features/vectors/. Accessed: 2026-06-11.
[5] Hyung-Chan An, Robert Kleinberg, and David B Shmoys. 2015. Improving Christofides’ algorithm for the st path TSP. Journal of the ACM (JACM) 62, 5 (2015), 1–28.
[6] Fabien André, Anne-Marie Kermarrec, and Nicolas Le Scouarnec. 2016. Cache locality is not enough: High-performance nearest neighbor search with product quantization fast scan. In 42nd International Conference on Very Large Data Bases, Vol. 9. 12.
[7] Sunil Arya and David M Mount. 1993. Approximate nearest neighbor queries in fixed dimensions.. In SODA, Vol. 93. Citeseer, 271–280.
[8] Martin Aumüller, Erik Bernhardsson, and Alexander Faithfull. 2020. ANN-Benchmarks: A Benchmarking Tool for Approximate Nearest Neighbor Algorithms. Information Systems 87 (2020), 101374. doi: 10.1016/j.is.2019.02.006
[9] Artem Babenko and Victor Lempitsky. 2014. Additive quantization for extreme vector compression. In Proceedings of the IEEE Conference on Computer Vision and Pattern Recognition. 931–938.
[10] Artem Babenko and Victor Lempitsky. 2014. The inverted multi-index. IEEE transactions on pattern analysis and machine intelligence 37, 6 (2014), 1247–1260.
[11] Alina Beygelzimer, Sham Kakade, and John Langford. 2006. Cover trees for nearest neighbor. In Proceedings of the 23rd international conference on Machine learning. 97–104.
[12] ByteDance. 2026. Torch Object Storage. https://www.byteplus.com/en/product/tos. Accessed: 2026-06-11.
[13] Hue-Ling Chen and Ye-In Chang. 2005. Neighbor-finding based on space-filling curves. Information systems 30, 3 (2005), 205–226.
[14] Qi Chen, Bing Zhao, Haidong Wang, Mingqin Li, Chuanjie Liu, Zengzhong Li, Mao Yang, and Jingdong Wang. 2021. SPANN: Highly-efficient Billion-scale Approximate Nearest Neighborhood Search. In Advances in Neural Information Processing Systems, M. Ranzato, A. Beygelzimer, Y. Dauphin, P.S. Liang, and J. Wortman Vaughan (Eds.), Vol. 34. Curran Associates, Inc., 5199–5212. https://proceedings.neurips.cc/paper_files/paper/2021/file/299dc35e747eb77177d9cea10a802da2-Paper.pdf
[15] Paolo Ciaccia, Marco Patella, and Pavel Zezula. 1997. M-tree: An Efficient Access Method for Similarity Search in Metric Spaces. In Proceedings of the 23rd International Conference on Very Large Data Bases (VLDB ’97). Morgan Kaufmann Publishers Inc., San Francisco, CA, USA, 426–435.
[16] Mayur Datar, Nicole Immorlica, Piotr Indyk, and Vahab S Mirrokni. 2004. Locality-sensitive hashing scheme based on p-stable distributions. In Proceedings of the twentieth annual symposium on Computational geometry. 253–262.
[17] Cheng-Hao Deng and Wan-Lei Zhao. 2018. Fast k-Means Based on k-NN Graph. In 2018 IEEE 34th International Conference on Data Engineering (ICDE). 1220–1223. doi: 10.1109/ICDE.2018.00115
[18] Matthijs Douze, Alexandr Guzhva, Chengqi Deng, Jeff Johnson, Gergely Szilvasy, Pierre-Emmanuel Mazaré, Maria Lomeli, Lucas Hosseini, and Hervé Jégou. 2024. The Faiss library. arXiv:2401.08281 [cs.LG]
[19] Dominik Durner, Viktor Leis, and Thomas Neumann. 2023. Exploiting cloud object storage for high-performance analytics. Proceedings of the VLDB Endowment 16, 11 (2023), 2769–2782.
[20] Gil Einziger, Roy Friedman, and Ben Manes. 2017. Tinylfu: A highly efficient cache admission policy. ACM Transactions on Storage (ToS) 13, 4 (2017), 1–31.
[21] Faiss contributors. [n. d.]. Faiss FAQ. https://github.com/facebookresearch/faiss/wiki/FAQ. Accessed: 2026-10-18.
[22] Cong Fu, Chao Xiang, Changxu Wang, and Deng Cai. 2019. Fast Approximate Nearest Neighbor Search with the Navigating Spreading-out Graph. Proceedings of the VLDB Endowment 12, 5 (2019), 461–474. doi: 10.14778/3303753.3303754
[23] Junhao Gan, Jianlin Feng, Qiong Fang, and Wilfred Ng. 2012. Locality-sensitive hashing scheme based on dynamic collision counting. In Proceedings of the 2012 ACM SIGMOD international conference on management of data. 541–552.
[24] Jianyang Gao, Yutong Gou, Yuexuan Xu, Jifan Shi, Zhonghao Yang, and Cheng Long. 2025. The RaBitQ Library. In The 1st Workshop on Vector Databases.
[25] Jianyang Gao, Yutong Gou, Yuexuan Xu, Yongyi Yang, Cheng Long, and Raymond Chi-Wing Wong. 2025. Practical and asymptotically optimal quantization of high-dimensional vectors in euclidean space for approximate nearest neighbor search. Proceedings of the ACM on Management of Data 3, 3 (2025), 1–26.
[26] Jianyang Gao and Cheng Long. 2023. High-dimensional approximate nearest neighbor search: with reliable and efficient distance comparison operations. Proceedings of the ACM on Management of Data 1, 2 (2023), 1–27.
[27] Jianyang Gao and Cheng Long. 2024. RaBitQ: Quantizing High-Dimensional Vectors with a Theoretical Error Bound for Approximate Nearest Neighbor Search. Proc. ACM Manag. Data 2, 3, Article 167 (May 2024), 27 pages. doi: 10.1145/3654970
[28] Michael R Garey and David S Johnson. 1979. Computers and Intractability: A Guide to the Theory of NP-Completeness. W. H. Freeman and Company.
[29] Tiezheng Ge, Kaiming He, Qifa Ke, and Jian Sun. 2014. Optimized product quantization. IEEE transactions on pattern analysis and machine intelligence 36, 4 (2014), 744–755.
[30] Google Cloud. 2026. Google Cloud Storage. https://cloud.google.com/storage. Accessed: 2026-10-18.
[31] Yutong Gou, Jianyang Gao, Yuexuan Xu, and Cheng Long. 2025. SymphonyQG: towards symphonious integration of quantization and graph for approximate nearest neighbor search. Proceedings of the ACM on Management of Data 3, 1 (2025), 1–26.
[32] Yan Gu, Zachary Napier, Yihan Sun, and Letong Wang. 2022. Parallel cover trees and their applications. In Proceedings of the 34th ACM Symposium on Parallelism in Algorithms and Architectures. 259–272.
[33] Ruiqi Guo, Philip Sun, Erik Lindgren, Quan Geng, David Simcha, Felix Chern, and Sanjiv Kumar. 2020. Accelerating large-scale inference with anisotropic vector quantization. In International Conference on Machine Learning. PMLR, 3887–3896.
[34] David Hilbert. 1935. Über die stetige Abbildung einer Linie auf ein Flächenstück. In Dritter Band: Analysis· Grundlagen der Mathematik· Physik Verschiedenes: Nebst Einer Lebensgeschichte. Springer, 1–2.
[35] JA Hoogeveen. 1991. Analysis of Christofides’ heuristic: Some paths are more difficult than cycles. Operations Research Letters 10, 5 (1991), 291–295.
[36] Qiang Huang, Jianlin Feng, Yikai Zhang, Qiong Fang, and Wilfred Ng. 2015. Query-aware locality-sensitive hashing for approximate nearest neighbor search. Proceedings of the VLDB Endowment 9, 1 (2015), 1–12.
[37] IBM. 2026. IBM Cloud Object Storage. https://www.ibm.com/products/cloud-object-storage. Accessed: 2026-10-18.
[38] Piotr Indyk and Rajeev Motwani. 1998. Approximate nearest neighbors: towards removing the curse of dimensionality. In Proceedings of the thirtieth annual ACM symposium on Theory of computing. 604–613.
[39] Elias Jääsaari, Ville Hyvönen, Matteo Ceccarello, Teemu Roos, and Martin Aumüller. 2026. VIBE: Vector Index Benchmark for Embeddings. Journal of Data-centric Machine Learning Research (2026). https://vector-index-bench.github.io/
[40] Suhas Jayaram Subramanya, Fnu Devvrit, Harsha Vardhan Simhadri, Ravishankar Krishnawamy, and Rohan Kadekodi. 2019. Diskann: Fast accurate billion-point nearest neighbor search on a single node. Advances in Neural Information Processing Systems 32 (2019).
[41] Herve Jegou, Matthijs Douze, and Cordelia Schmid. 2011. Product quantization for nearest neighbor search. IEEE transactions on pattern analysis and machine intelligence 33, 1 (2011), 117–128.
[42] William B Johnson and Joram Lindenstrauss. 1984. Extensions of Lipschitz mappings into a Hilbert space 26. Contemporary mathematics 26 (1984), 28.
[43] Leonardo Kuffo and Peter Boncz. 2026. Stop Indexing at Full Precision: Revisiting Clustering for Vector Embeddings. In Proceedings of the VLDB Workshop on Vector Databases. https://arxiv.org/abs/2608.14648
[44] Leonardo Kuffo, Sven Hepkema, and Peter Boncz. 2026. A Super Fast K-means for Indexing Vector Embeddings. arXiv preprint arXiv:2603.20009 (2026).
[45] Leonardo Kuffo, Elena Krippner, and Peter Boncz. 2025. PDX: A data layout for vector similarity search. Proceedings of the ACM on Management of Data 3, 3 (2025), 1–26.
[46] LanceDB. 2026. LanceDB: Developer-Friendly OSS Embedded Retrieval Library for Multimodal AI. https://docs.lancedb.com/. Accessed: 2026-06-11.
[47] Zhaoheng Li, Wei Ding, Silu Huang, Zikang Wang, Yuanjin Lin, Ke Wu, Yongjoo Park, and Jianjun Chen. 2025. Cloud-Native Vector Search: A Comprehensive Performance Analysis. arXiv:2511.14748 [cs.DB] https://arxiv.org/abs/2511.14748
[48] Swanwa Liao, Mario Alberto López, and Scott T Leutenegger. 2001. High dimensional similarity search with space filling curves. In Proceedings 17th international conference on data engineering. IEEE, 615–622.
[49] Yu A Malkov and Dmitry A Yashunin. 2018. Efficient and robust approximate nearest neighbor search using hierarchical navigable small world graphs. IEEE transactions on pattern analysis and machine intelligence 42, 4 (2018), 824–836.
[50] Microsoft Azure. 2026. Azure Blob Storage | Microsoft Azure. https://azure.microsoft.com/en-us/products/storage/blobs. Accessed: 2026-06-11.
[51] Guy M Morton. 1966. A computer oriented geodetic data base and a new technique in file sequencing. International Business Machines Company.
[52] Oracle. 2026. Oracle Cloud Infrastructure Object Storage. https://docs.oracle.com/en-us/iaas/Content/Object/. Accessed: 2026-10-18.
[53] Zero Qu, Erik Lindgren, Dima Kotlyarov, and Sergei Tsarev. 2026. Decoupled by Design: Billion-Scale AI Search. https://www.databricks.com/blog/decoupled-design-billion-scale-vector-search. Accessed: 2026-06-11.
[54] Daniel J Rosenkrantz, Richard E Stearns, and Philip M Lewis, II. 1977. An analysis of several heuristics for the traveling salesman problem. SIAM journal on computing 6, 3 (1977), 563–581.
[55] Hans Sagan. 2012. Space-filling curves. Springer Science & Business Media.
[56] Harsha Vardhan Simhadri, George Williams, Martin Aumüller, Matthijs Douze, Artem Babenko, Dmitry Baranchuk, Qi Chen, Lucas Hosseini, Ravishankar Krishnaswamy, Gopal Srinivasa, Suhas Jayaram Subramanya, and Jingdong Wang. 2022. Results of the NeurIPS’21 Challenge on Billion-Scale Approximate Nearest Neighbor Search. In Proceedings of the NeurIPS 2021 Competitions and Demonstrations Track (Proceedings of Machine Learning Research, Vol. 176). PMLR, 177–189. https://proceedings.mlr.press/v176/simhadri22a.html
[57] Jack Spalding-Jamieson, Eliot Wong Robson, and Da Wei Zheng. 2025. Scalable k-Means Clustering for Large k via Seeded Approximate Nearest-Neighbor Search. arXiv:2502.06163 [cs.LG] https://arxiv.org/abs/2502.06163
[58] Yifang Sun, Wei Wang, Jianbin Qin, Ying Zhang, and Xuemin Lin. 2014. SRS: solving c-approximate nearest neighbor queries in high dimensional euclidean space with a tiny index. Proceedings of the VLDB Endowment 8, 1 (2014), 1–12. doi: 10.14778/2735461.2735462
[59] Yufei Tao, Ke Yi, Cheng Sheng, and Panos Kalnis. 2010. Efficient and accurate nearest neighbor and closest pair search in high-dimensional space. ACM Transactions on Database Systems (TODS) 35, 3 (2010), 1–46.
[60] Tencent Cloud. 2026. Tencent Cloud Object Storage. https://www.tencentcloud.com/products/cos. Accessed: 2026-06-11.
[61] Turbopuffer. 2026. Turbopuffer System Architecture: Serverless, Object-Storage-First Vector Search. https://turbopuffer.com/docs/architecture. Accessed: 2026-06-11.
[62] Shay Vargaftik, Ran Ben-Basat, Amit Portnoy, Gal Mendelson, Yaniv Ben-Itzhak, and Michael Mitzenmacher. 2021. DRIVE: One-bit Distributed Mean Estimation. In Advances in Neural Information Processing Systems, Vol. 34. 362–377. https://proceedings.neurips.cc/paper/2021/hash/0397758f8990c1b41b81b43ac389ab9f-Abstract.html
[63] Shay Vargaftik, Ran Ben-Basat, Amit Portnoy, Gal Mendelson, Yaniv Ben-Itzhak, and Michael Mitzenmacher. 2022. EDEN: Communication-Efficient and Robust Distributed Mean Estimation for Federated Learning. In Proceedings of the 39th International Conference on Machine Learning (Proceedings of Machine Learning Research, Vol. 162). PMLR, 21984–22014. https://proceedings.mlr.press/v162/vargaftik22a.html
[64] Yan Wang, Jian Zhou, Sai Huang, Chao Dou, Hanwen Tian, Zhijie Jiang, Zongning Zhang, Xiaoqi Li, Zhencan Peng, Chunhui Shen, Wei Zhang, Feifei Li, and Dong Deng. 2026. LindormVector: A Distributed Vector Engine on a Cloud-Native Multi-Model NoSQL Database. In Companion of the International Conference on Management of Data (Bengaluru, India) (SIGMOD Companion ’26). Association for Computing Machinery, New York, NY, USA, 451–463. doi: 10.1145/3788853.3803088
[65] Yuming Xu, Hengyu Liang, Jin Li, Shuotao Xu, Qi Chen, Qianxi Zhang, Cheng Li, Ziyue Yang, Fan Yang, Yuqing Yang, Peng Cheng, and Mao Yang. 2023. SPFresh: Incremental In-Place Update for Billion-Scale Vector Search. In Proceedings of the 29th Symposium on Operating Systems Principles (Koblenz, Germany) (SOSP ’23). Association for Computing Machinery, New York, NY, USA, 545–561. doi: 10.1145/3600006.3613166
[66] Mingyu Yang, Liuchang Jing, Wentao Li, and Wei Wang. 2026. Quantization Meets Projection: A Happy Marriage for Approximate $k$-Nearest Neighbor Search. Proceedings of the VLDB Endowment 19, 6 (2026), 1240–1249. doi: 10.14778/3797919.3797931
[67] Amir Zandieh, Majid Daliri, Majid Hadian, and Vahab Mirrokni. 2026. TurboQuant: Online Vector Quantization with Near-optimal Distortion Rate. In International Conference on Learning Representations (ICLR). https://openreview.net/forum?id=tO3ASKZlok
[68] Rico Zenklusen. 2019. A 1.5-approximation for path TSP. In Proceedings of the thirtieth annual ACM-SIAM symposium on discrete algorithms. SIAM, 1539–1549.