跳到主要内容

终端是如何工作的

· 阅读需 5 分钟

原文: How Terminals Work

  1. Terminal 就是一个由等大单元格组成的网格.

  2. 每个单元格只能存放一个字符加上一些样式(颜色,加粗,下划线).

  3. 转义序列(Escape Sequences): 特殊字符序列控制着 Terminal 的行为(移动光标, 改变颜色, 清空屏幕)

  4. 当你按一下个键时, 终端会向程序发送转义之后的字符序列. (终端默认不会发送鼠标事件。程序需要先请求鼠标追踪功能,之后点击操作才会转换为带坐标的转义序列)

  5. Signals(信号量): Ctrl + C 组合键不会输入字符,而是会发送一个信号. 终端会拦截特殊的组合键, 并转化为操作系统层面的事件(信号量), 用于中断或控制程序运行.

    • ctrl + c 中断 Interrupt

    • ctrl + z 暂停程序 Suspend

    • ctrl + D 文件结束 End of file

    普通按键会转换为字节流传输给程序,而信号键则被终端拦截并转换为操作系统级别的事件,用于中断或控制进程。

  6. Raw vs Cooked Mode

    • Cooked mode: 需要输入整行后按回车键 (Shell, bash, zsh, cat)
    • Raw mode: 每个按键都会直接发送给程序. (vim, htop, ssh, less)
  7. The Round Trip: 每次按键都会通过终端栈传递给程序,随后输出结果又会回流到屏幕上显示。

    1. 每按下按键
    2. 终端键按键编码成字符
    3. 将字符传输给 Shell 进程
    4. 终端将输入的字符显示出来
    5. 按下回车键(Shell 执行命令)
    6. Shell 将执行结果传输给终端
    7. 终端将结果显示出来

    1. keystore -> 2. encode -> 3. Shell -> 4. execute -> 5. output -> 5. render (repeat!)

  8. 构建复杂终端用户界面 (Building Complex TUIs)

    • htop, vim 这种高级 TUI 会将屏幕划分为多个区域.
      • 每个区域都有自己的内容, 调整大小的方式 (用字符而非像素来构建图形用户界面)
      • 以字符单元格来存储其坐标,尺寸使用制表符 (┌─┐│) 绘制可视化边框
      • 当内容发生变化时, 文本用户界面会自动重新计算这些参数.
      • 每次只会有一个区域获得焦点(focused)
      • 调整终端窗口大小时, 系统会发送 SIGWINCH 信号. TUI 会通过 ioctl() 获取新尺寸,重新计算各个区域尺寸并刷新整个屏幕显示.
      • 先在内存中完成绘制,再一次性输出全部内容。
  9. 终端有 2 套屏幕, 终端根据输入在这 2 套屏幕之间切换.

    • normal(带滚动),
    • alternate(供应用程序作画布使用) (vim, kess, man, htop, tmux 等终端应用都会启用备用屏幕)
  10. Terminal Icons, 就是特殊渲染的 Unicode 字符

  11. 状态管理

    • 在 Claude Code 按下 shift+ tab 组合键时, 终端不会记住任何状态(而是由 Claude Code 在内存中处理)
      • 状态变化时 Claude Code 会重新绘制屏幕的相关部分
      • Claude Code 会保存下面这些程序变量. 注意: 终端本身并不存储应用的状态---它仅显示你发送的字符内容
        • currentMode
        • inputBuffer
        • history
    • Claude Code 可以将状态保存到文件中.
  12. Text Selection & Cursor Positioning

    • 无法通过点击来移动光标
    • 终端本质上是一个被动的显示设备。它只在应用程序指定的位置显示字符。光标位置完全由正在运行的程序控制,终端只能通过发送按键事件来施加影响,而这些事件最终由程序来解析和处理。
  13. 终端术语表

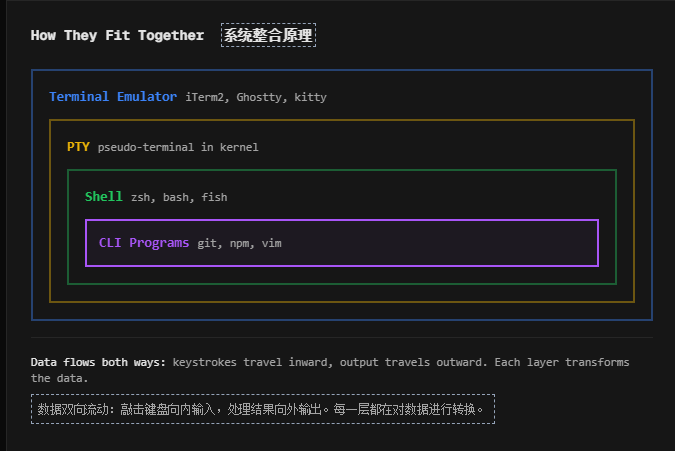
    • Terminal: 终端, 最早终端指的是连接计算机的带屏幕和键盘的物理设备. 现在说终端一般都是指终端模拟器.
    • Terminal Emulator: 终端模拟器
      • iTerm2
      • windows Terminal
      • kitty
    • Shell: 一个解释命令的程序。Shell 负责读取你输入的内容、执行程序,并处理诸如管道、重定向和脚本编写等任务。Terminal 只是那个窗口;Shell 才是运行在其中的程序。
      • sh
      • bash
      • zsh
      • fish
      • ksh
      • tsch
      • nushell
    • bash: 大多数 linux 操作系统默认的 Shell
    • console
    • CLI
      • git
      • npm
      • docker
      • curl

  14. 常见问题

    1. 终端设置与 Shell 配置的区别?
      • 终端设置是软件方面的, 只能修改终端界面的显示, 如字体, 颜色, 大小
      • Shell 配置是需要到服务器上修改文件的.
    2. 通过上下箭头调出之前的命令是 Shell 程序.
    3. 为什么修改 .zshrc 要重启终端?
      • 因为 .zshrc 是 Shell 的配置文件. 已运行的 Shell 仅在启动时读取一次 .zshrc 文件.
      • 通过执行 source ~/.zshrc 让 Shell 重新加载配置
    4. 通过 echo $SHELL 查看使用的是哪个 Shell
    5. 通过 chsh -s /bin/zsh 切换 Shell
    6. 通过 cat /etc/shells 查看支持的 Shell 列表

AI 时代,应该如何学习?

· 阅读需 3 分钟

2026 年, AI 的发展趋势已势不可挡了. 我们能做到只能顺应趋势, 积极拥抱 AI, 学会如何去驾驭 AI.

对于只是把 AI 当作一个搜索引擎的我来说, 还是有很多需要学习的内容.

要选择 AI 容易理解和操作的技术栈。

设计 AI 产品的时候要以 AI 为中心。 现在的流程都是为人设计的,如果让 AI 模仿人的操作,做出来的东西就会很割裂。

看不懂的名词​

这里连的每一个名词都可以单独出一篇文章.

Agent 分为 2 类

  1. 软件工程类 Agent (本质是流程驱动的软件开发,LLM 作为数据处理的后端)
    • Dify
    • Coze
    • n9n
  2. AI 原生 Agent(真正以 AI 驱动的 Agent)

Agent​

Agent 的定义:在人工智能领域,智能体被定义为任何能够通过传感器(Sensors)感知其所处环境(Environment),并自主地通过执行器(Actuators)采取行动(Action)以达成特定目标的实体。

  • Environment: Agent 所处的外部世界
  • Actuators: 可以是物理设备或代码(函数,脚本等)

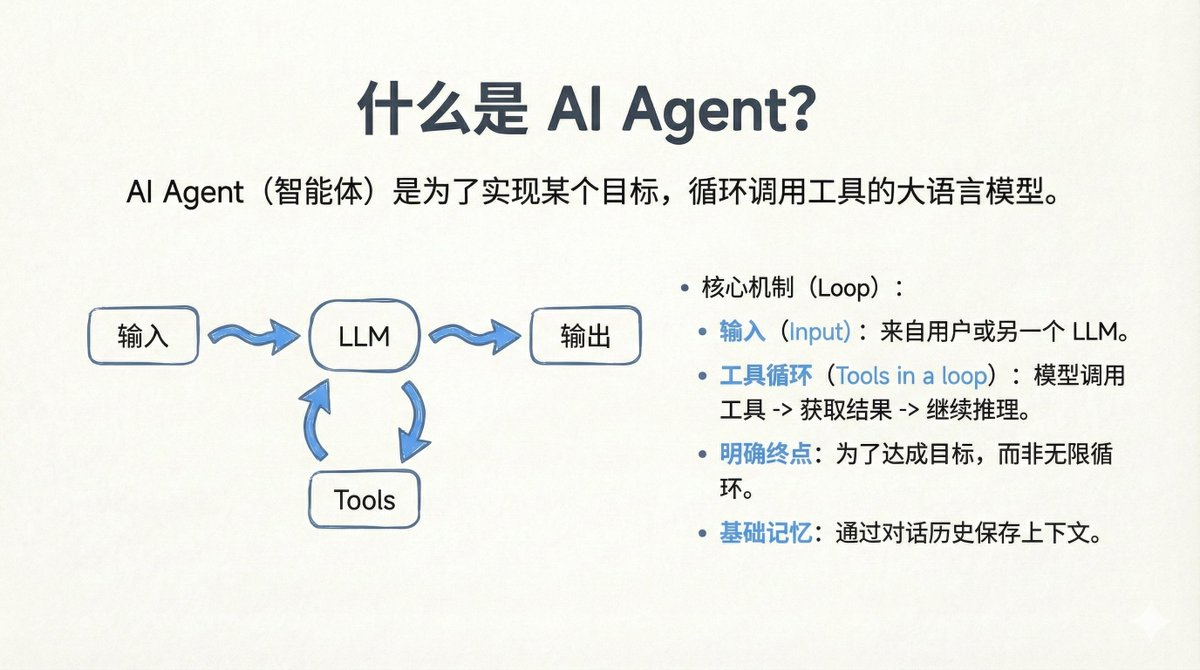
AI Agent 是为了实现某个目标,循环调用工具的大语言模型。

开发 AI Agent 挑战?

  1. prompt 工程
  2. 自我修复,要能够自动检测并修复生成代码中的错误。
  3. 上下文:无法全部方法放入 context。

(2026.1.9) 在生生产环境中, 68% 的 Agent 被限制在 10 步以内.

使用的方式:结构化控制流: 任务流程都是人画好的, AI 只能在这里面填空.

Skill​

Skill 提出的意义: 简化模型对工具使用上下文处理的困难程度,让它更好的执行任务拆分、检验的工作。

BTAS Budget-Aware Test-time Scaling 预算感知测试时缩放​

  1. 预算感知规划
    1. 维护一个树状的 checklist, 每个节点表示一个任务, 包含状态和资源消耗信息。
    2. Agent 不是一次性列出所有步骤,而是动态更新的。
      1. 新的信息可能会创建新的分支,解决待定步骤,废弃无效路径。
      2. 预算足够时扩大搜索深度,预算紧张时深挖验证深度.
  2. 预算感知验证

Agent 目前的困境​

目前的问题是需要给上下文减负。(沟通噪音和认知负担消耗了大量的上下文)

  1. 有效工具管理(如 skill 机制)
  2. 内建自我验证能力(如 BATS)
  3. 模型间高效沟通协议(A2A 协议), 未来肯定是会同时执行多个任务的(agent 与 Agent 之间需要沟通)。
    1. Claude Code 采用的是多 Agent 模式,主 Agent 负责与用户交互,并调度子 Agent 来完成特定子任务。

HTTP 协议

· 阅读需 1 分钟

HTTP/1.1 的问题​

  • 队头阻塞: 在 HTTP/1.1 中,一个连接上的请求是按照顺序执行的。 如果第一个请求处理比较慢,会阻塞后续的请求。(影响性能)
  • 头部冗余: 每个请求和响应都包含了完整的 HTTP 头部。(增加网络开销)
  • 多连接限制: 浏览器对同一域名同时建立 TCP 连接数有限制(6 个)

HTTP/2.0 的改进​

HTTP/2.0 需要 https

  • 头部压缩:使用 HPACK 对 HTTP 头部进行压缩
  • 流优先级: 允许客户端指定请求的优先级
  • 多路复用:允许在单个连接上并行处理多个请求和响应,允许对同一域名同时建立 TCP 连接数的限制数量也有所增加(100+)

Nginx 开启 HTTP/2.0​

只需要将 listen 443 ssl; 修改为 listen 443 ssl http2;

文件描述符限制

· 阅读需 1 分钟

临时将当前 Shell 会话的文件描述符限制到 65535

ulimit -n 65535
ulimit -n # 查看软限制
ulimit -Hn # 查看硬限制

如何做 AI Agent 喜欢的基础软件

· 阅读需 2 分钟

https://mp.weixin.qq.com/s/BZcRwgGZNinBK9K2L38LYg

Infra 软件的主要使用者, 正在从开发者迅速转向 AI Agent.

计算机底层的东西只从被发明出来之后就一直没变过.

  • 文件系统
  • 操作系统
  • 编程语言
  • 进程模型
  • I/O

现在的计算机世界都构建在这上面. 大模型在训练的时候,阅读了大量的代码. 对这些底层东西的"理解/认知"已经很深了.

所以设计给 Agent 使用的软件并不是去发明一套"全新的接口",而是贴近这些底层东西的.

好的心智模型的特征是它一定是可扩展的。

心智模型的理解: 就类似于 java 中的接口.心智模型(接口)不变, 实现是可以各种各样.

以文件系统为例: 在文件系统中有 目录,文件, echo, cat, ls, cp 等概念. 这个就理解为心智模型.

关系型数据库有 mysql, oracle, ms sql, sqlite 等. 都有 库, 表, 字段, 行 的概念, 都能增删改查. 只是语法有些许区别.

软件生态重不重要?

对于 Agent 来说, 并不关心你数据库选的是 mysql, oracle, ms sql, sqlite 哪个, 对于它们之间的区别 Agent 都能很快适配.

接口设计

对 Agent 来说好的接口设计应该

  • 可以被自然语言描述(Agent 对图片的理解不是很好, 你无法告诉 Agent 应该点击某个地方来交互, 应该使用自然语言告诉 Agent 如何交互. 你可能会在想 自然语言能描述的清楚吗? 实际上,大多数情况下, 还是很准的. 因为 Agent 在训练的时候,已经见过了无数类似的意图表达, 上下文约束和任务模式.)
  • 可以被符号逻辑固化 (需求能够通过代码准确描述, 以 sql 为例, 想要查询某个表的数据这个需求, 可以通过 select * from table_name 这个 sql 来完成)
  • 能够交付确定性的结果

当底层系统软件的心智模型是对的、接口的语义是稳定的、结果是可验证的时,上层调用者(Agent)的少量歧义并不会成为系统性问题。Agent 可以通过上下文、反馈和反复尝试来消解它(通常不会错得离谱),而不需要一开始就被迫进入一套过度严格的形式体系。

SSE 技术

· 阅读需 8 分钟

基本知识​

Server-Sent Events, 是一种基于 HTTP 协议的服务器推送技术. 只允许从服务端到客户端的单向推送.

  • 单向(服务端->客户端)
  • 自动重连
  • 基于 HTTP 协议
  • 浏览器支持比较好

使用场景

  1. 实时通知系统
  2. 实时更新的动态数据
  3. 数据流展示
  4. 数据更新频繁
  5. 低延迟单向通信
  6. ChatGPT 的流式输出

简单代码​

JS 通过 EventSource 对象与服务端建立连接

  1. new EventSource(url)
  2. onmessage
  3. onopen
  4. onerror
  5. close
const url = "xxxx";
// 1. 建立连接
const eventSource = new EventSource(url);

// 2. 消息事件
eventSource.addEventListener("message", this.handleMessage); // 还可以使用 onmessage 方法

// 3. 错误事件
eventSource.addEventListener("error", this.handleError); // 还可以使用 onerror 方法

// 4. 关闭 SSE 连接
eventSource.close();
@GetMapping(path = "/stream-flux", produces = MediaType.TEXT_EVENT_STREAM_VALUE)
public Flux<ServerSentEvent<MessageData>> streamFlux(@RequestParam("id") String id) {
return Flux.interval(Duration.ofSeconds(1))
.map(sequence ->
ServerSentEvent.<MessageData>builder()
.id(id) // id
.event("periodic-event") // 事件
.retry(Duration.ofSeconds(30)) // 重连时间
.data(new MessageData( // 自定义数据
UUID.randomUUID().toString(),
"heartbeat",
LocalDateTime.now(),
Map.of("clientId", UUID.randomUUID(),
"status", "connected"
)))
.build()
)
.take(1)
;
}

基本原理​

响应头​

服务器会设置三个响应头:

  1. Context-Type: text/event-stream; charset=utf-8:响应的内容类型是事件流
  2. Cache-Control: no-cache:禁止缓存响应内容,确保客户端每次都能接收到最新的数据。
  3. Connection: keep-alive 保持 HTTP 连接打开, 以便服务器可以持续向客户端推送数据。

如果使用到了 Nginx, 一般还会加上 x-accel-buffering: no, 让 Nginx 不缓冲后端服务器的响应

SSE 报文​

服务端响应报文:

: 注释\n
id: xxx\n
retry: 5000\n
event:message\n
data: xxxx\n
\n
  1. 每行结束都要有一个\n
  2. : 注释
  3. id: 消息 id
  4. retry: 设置断线重连等待的时间
  5. event: 设置事件名
  6. data: 数据
  7. 空行表示消息结束

SSE 与 Websocket 对比​

  • ws 是双向的, 因此长连接情况下 ws 数据传输效率会比 SSE 高.
  • 相对于 SSE 的 HTTP 协议, ws 协议的开销更大, 实现起来也更复杂.
  • ws 支持传输二进制, SSE 只支持 UTF-8 文本(二进制类格式可以通过 base64 编码成文本进行传输)
  • SSE 内置自动重连机制, ws 需要手动实现重连和心跳机制.

自动重连机制​

当 HTTP 长连接因网络波动, 服务器重启或者其他异常断开时, EventSource 会自动在一段固定的间隔(未设置 retry 时,默认是 3000ms)后重新发起连接请求。

重连等待时间: 可以通过服务端响应的事件流设置 retry 字段告知客户端下次重连等待的时间。 如 retry: 10000, 等待 10s 再重新连接.

断点续传:Last-Event-ID, 如果发生了重连, 浏览器会把最近接收到的 id 通过 Last-Event-ID 请求头传给服务端. 服务端可以根据这个字段续传, 避免数据丢失.

异常处理,EventSource.onerror 可以监听异常事件。

断线重连的几种情况​

  1. EventSource 自动重连
const source = new EventSource(url);

在出现异常情况之后, 客户端会自动重连.

下面几种情况, 浏览器端在连接断开后会重新建立连接请求。

  • 网络故障
  • 服务器崩溃
  • 连接超时
  • 服务器主动断开(调用了 emitter.complete())

SSE 会无限次重连,直到成功或被手动关闭。

不会重连的情况

  1. 客户端手动调用 eventSource.close()
  2. 服务器返回 HTTP 204 No Content
  3. 服务器返回非 text/event-stream 的 Content-Type
  4. 服务区返回 HTTP 错误码(204, 401,403,404 等)

错误处理, 不同类型的错误需要使用不同的处理策略

  • 暂时性错误(重连)
  • 致命错误(需要向用户报告)
  1. 服务端控制重连的时机

服务端通过设置 retry 来控制客户端在断连之后等待重连的时间.

  1. 异常情况下的手动重连

通过监听 EventSource.onerror 事件来实现断线重连机制。

const source = new EventSource(url);

// 在 onerror 中实现断线重连
source.onerror = function (event) {
setTimeout(() => {
source = new EventSource(url);
}, 1000);
};
  1. 服务端主动要求客户端重连

服务器端可以通过发送特定事件(如 reconnect )来要求客户端重新连接。

// 服务器端设置重连延迟
emitter.send(SseEmitter.event()
.reconnectTime(5000L) // 5秒后重连
.data("数据"));

上面代码对应的报文

retry: 5000\n
data: 数据\n
\n
// 客户端
eventSource.addEventListener("reconnect", function (e) {
console.log("收到重连指令:", e.data);
eventSource.close(); // 关闭当前连接
setTimeout(() => {
connect(); // 重新连接
}, 5000);
});

执行这段代码后,客户端会先断开连接,然后在 5s 后重新连接。

Authentication 问题​

  1. 同源, 会直接携带 cookie

  2. 跨源, (处于同一主域名的情况下可以使用 withCredentials 来是跨源请求携带 cookie)

    const eventSource = new EventSource("https://api.myapp.com/sse", {withCredentials:true})
  3. 使用 npm event-source-polyfill 包提供的 EventSourcePolyfil 来携带请求头

    const headers = {
    "Authorization": "..." // somewhat can update this token when it's refreshed
    }
    const eventSource = new EventSourcePolyfill("/sse", { headers })

    需要注意的是, EventSourcePolyfil 会将 Last-Event-ID 作为请求参数传递,而不是请求头

注意事项​

如果使用 Nginx 配置需要将 proxy_buffering 关闭

proxy_buffering off;

设置响应头 x-accel-buffering 也可以让 Nginx 不缓冲后端服务器的响应

x-accel-buffering: no

分布式架构设计​

  1. 主题分片 Topic Sharding
    • 按业务领域分片
      • 用户消息
      • 订单消息
      • 通知消息
    • 用户分片: 根据 userID hash 分配到不同的服务器

安全问题​

  1. 防止 XSS 攻击: 一般来说, SSE 接收到数据大多数情况下会显示到前端, 因此需要防范 XSS 攻击

  2. 验证连接请求: 检查 Referer 头或使用身份验证令牌.

  3. 限制连接数据, 避免资源耗尽

    • 应用层面: 对每个连接计数

    • Nginx 层面: 限制每个 IP 的连接数

        # /etc/nginx/nginx.conf 或站点配置文件

      # limit_conn_zone 用于定义连接限制的存储区域
      # $binary_remote_addr 使用客户端 IP地址的二进制格式作为 key
      # sse_conn 共享内存区域的名称(这个是自定义的)
      # 10m 分配 10MB 内存,大概可以存储 160,000 个 IP 地址的连接状态
      limit_conn_zone $binary_remote_addr zone=sse_conn:10m;

      # 请求速率限制
      # rate=10r/s, 单 IP 每秒限制 10 个请求
      limit_req_zone $binary_remote_addr zone=sse_req:10m rate=10r/s;

      server {
      listen 80;
      server_name example.com;

      location /events {
      # 每个 IP 最多 10 个连接
      # limit_conn 应用连接限制指令
      # sse_conn 前面定义的共享内存区域
      # 10 每个 IP 最大连接数
      limit_conn sse_conn 10;

      # 请求速率限制
      # burst=20 令牌桶容量 20, 允许短时间内处理 20 个请求
      limit_req zone=sse_req burst=20;

      # SSE 特殊配置
      proxy_pass http://localhost:3000;
      proxy_set_header Connection '';
      proxy_http_version 1.1;
      chunked_transfer_encoding off;
      proxy_buffering off;
      proxy_cache off;
      proxy_read_timeout 24h;
      }
      }
    • 系统层面

      • 修改文件描述符 (默认是 1024)

        # 临时将当前 Shell 会话的文件描述符限制到 65535
        # -n 指定文件描述符(nofile)参数
        ulimit -n 65535

        # 永久修改 /etc/security/limits.conf
        echo "* soft nofile 65535" | sudo tee -a /etc/security/limits.conf # 软限制
        echo "* hard nofile 65535" | sudo tee -a /etc/security/limits.conf # 硬限制

        # 修改系统级别限制
        echo "fs.file-max = 2097152" | sudo tee -a /etc/sysctl. conf # 内核参数

        cat /proc/sys/fs/file-max # 查看系统限制
        cat /proc/sys/fs/file-nr # 查看当前使用情况

        sudo sysctl -w fs.file-max=2097152 # 直接修改(临时)
        sudo sysctl -p # 从文件加载(永久)
      • 优化 TCP 连接参数

        # /etc/sysctl.conf
        # 客户端连接请求 → [SYN队列] → [Accept队列] → accept()处理
        net.core.somaxconn = 4096 # 设置listen() 系统调用的最大连接队列长度
        net.ipv4.tcp_max_syn_backlog = 4096 # 设置 SYN 半连接队列的最大长度
        net.ipv4.ip_local_port_range = 1024 65535 # 可使用的临时端口范围
        net. ipv4.tcp_tw_reuse = 1 # 允许将处于 TIME_WAIT 状态的 socket 用于新的 TCP 连接
  4. 监控和日志记录

  5. 访问控制,只有授权用户才能接受敏感数据

性能优化​

  1. 使用 gzip 对数据进行压缩
  2. 浏览器对同一网站打开的连接数(HTTP/1.1 6 个). 如果允许的话, 建议使用 HTTP/2 协议, 它支持更多并发连接(100+).
    • 需要避免每位用户的连接数量过多
  3. 引入心跳机制,定时发送 : heartbeat (以冒号开头表示在注释,会被 EventSource API 忽略)
  4. 优化数据降低带宽,只发送变更的数据
  5. 需要避免常见的资源泄露
    • 未关闭的数据库连接
    • 为已断开连接的客户端运行后台任务
    • 处理用户请求时分配的内存
    • 流式传输过程中创建的临时文件或缓冲区

参考文章​

Spring 时间格式格式化问题

· 阅读需 1 分钟

问题: 在接口响应的实体类的字段上加 @DateTimeFormat(pattern = "yyyy-MM-dd HH:mm:ss") 发现这个注解没有生效.

@DateTimeFormat 使用的场景是: 用于 Spring MVC 的数据绑定和格式化.

  • 在 @RequestParam 的字段上
  • 在 @PathVariable 的字段上
  • 在 @ModelAttribute 的实体类字段上

原因: @DateTimeForma 不生效的原因是 @DateTimeForma 不支持 @RequestBody 的反序列化.

解决方案: 改用 @JsonFormat 注解

@JsonFormat 是 Jackson 提供的注解, 用于 JSON 序列化和反序列化.

  • @RequestBody
  • @ResponseBody / @RestController
  • 需要序列化或反序列化实体类的字段上
  • Feign Client 调用
  • Redis 序列化
  • MQ 消息
  • Websocket 消息

html 页面乱码问题

· 阅读需 1 分钟

问题:在 Docusaurus 在 static 文件夹下添加一个自己写的 html 文件,在浏览器访问会出现乱码

解决方法:

添加 <meta charset="UTF-8" />

<head>
<meta charset="UTF-8" />
<meta name="viewport" content="width=device-width, initial-scale=1.0" />
</head>

AI 对就业的影响

· 阅读需 2 分钟
  • 短期: 其影响范围仍集中于初级信息相关行业.
    • 例如程序员, IT 高速发展的时候, 创造了很多程序员, 只从事简单脑力劳动的部分程序员,在短期内会受到 AI 的冲击.所有,不要追求浅层的技巧,要追寻其中的道(核心原理)
  • 长期: 最终或许仅剩下最高级别的工作岗位由人类承担.

AI 替代的过程是逐步的.

  1. 若想让计算机实现特定编程需求,使用者自身必须具备编程能力.(不然一旦出现漏洞,很难排查问题)
  2. 当前计算机需解决的问题复杂程度与技术工具的提升速率同步推进,但问题复杂程度的提升速度,实际上远超技术本身的提升速度

一般具体技能的生命周期仅为 5~6 年.

广博且多元的知识储备.

需要掌握的知识真的变多了.

写作能力还是很重要的(逻辑清晰表达的能力,以及运行统计视角分析和解读数据的能力.).

有观点,并从事实去论证这个观点.

中国产业工人不到 2 亿人, 让 2 亿人放开量生产,两倍的地球人都消费不完.

有了 AI 之后,学习知识的门槛在变低.

未来更需要驾驭 AI 的人.

未来的活会越来越难. 以前十个人干的话现在一个人就能干. 但现在一个人干的活,未来需要十个人干(因为功能/需求复杂了).

未来,创新类工作会增加. 因为人们的精神消费需求会越来越多.

如何优雅地写作

· 阅读需 1 分钟

写作需要阅读, 研究, 思考和修订.

  1. 准备阶段
    • 多读书
      • 读各种各样的书
      • 保持稳定的阅读习惯
      • 做好摘抄和储备
    • 寻找创作地
    • 选择写作方式
    • 头脑风暴
      • 是你要表达的东西吗?
      • 主要观点是什么?
      • 会产生歧义吗?
      • 读者会对它感兴趣吗?
    • 研究
      • 确保你写的东西真实可靠.
      • 尽信书不如无书.
  2. 写草稿
    • 第一稿: 写一个想法清单
      • 可以是任何东西
    • 设定时间,自由写作
      • 类似于番茄钟, 到点为止.
    • 第二稿: 对草稿进行编辑
      • 逻辑
      • 错别字和语法
      • 前后保持一致性
      • 简化表达
    • 校对
    • 第三稿: 润色
  3. 发表文章
    • 平台
    • 排版
      • 行间距,字间距,对齐方式,图片插入等
    • 对某一领域的文章汇集成专栏